


H1. 제14부. 가설검증과 연구결과는 어떻게 해석하는가? ― Hypothesis Testing(가설검증)·p-value(유의확률)·Confidence Interval(신뢰구간)·Effect Size(효과크기)와 Research Findings(연구결과) 작성 (공인중개사 30년 실무 경험)
부제
제13부에서 수행한 Statistical Analysis(통계분석)의 결과를 바탕으로 Hypothesis(가설)를 어떻게 판단하고, Regression Coefficient(회귀계수)·p-value(유의확률)·Confidence Interval(신뢰구간)·Effect Size(효과크기)를 어떻게 해석하여 Research Findings(연구결과)로 작성하는가
본 글은 국내외 선행연구, 관계 법령, 공공기관 자료 및 공인중개사 30년 실무 경험을 바탕으로 작성한 논문형 연구 블로그입니다.
컴퓨터공학 · 부동산학 · 경영학 · 신학 · 경영학 박사과정 · Golf Teaching Pro
「초록(Abstract)에서 소논문(Research Paper)까지 ― 대학원생을 위한 연구방법론과 논문작성 16부 완성 과정」의 제14부에서는 제13부에서 수행한 Statistical Analysis(통계분석)의 결과를 실제 Research Findings(연구결과)로 해석하는 방법을 살펴본다.
제13부까지 연구는 다음과 같이 진행되었다.
Research Problem(연구문제)
→ Literature Review(선행연구 검토)
→ Research Gap(연구공백)
→ Research Question(연구질문)
→ Theory(이론)
→ Variables(변수)
→ Research Model(연구모형)
→ Hypothesis(가설)
→ Measurement(측정)
→ Data Collection(자료수집)
→ Statistical Analysis(통계분석)
이제 연구자는 가장 중요한 질문을 해야 한다.
“통계결과가 실제로 무엇을 의미하는가?”
예를 들어 다음과 같은 가설을 세웠다고 하자.
H1.
“IC 접근거리가 짧을수록 산업용 토지 실거래가격은 높을 가능성이 있다.”
통계프로그램에서 다음 결과가 나왔다고 가정해 보자.
β = -0.08
p = 0.02
95% Confidence Interval(95% 신뢰구간) = -0.14 ~ -0.02
이 결과를 보고 단순히,
“p<0.05이므로 H1은 참이다.”
라고 작성하면 충분하지 않다.
연구자는 다음을 함께 해석해야 한다.
회귀계수의 방향은 무엇인가?
관계의 크기는 어느 정도인가?
신뢰구간은 얼마나 넓은가?
실무적으로 의미 있는 차이인가?
연구설계상 인과관계를 주장할 수 있는가?
다른 변수의 영향을 충분히 고려했는가?
따라서 제14부의 핵심은 통계숫자를 연구의 언어로 바꾸는 것이다.
Statistical Output(통계출력)
→ Hypothesis Test(가설검증)
→ Coefficient(계수)
→ p-value(유의확률)
→ Confidence Interval(신뢰구간)
→ Effect Size(효과크기)
→ Practical Meaning(실무적 의미)
→ Research Findings(연구결과)
H2. 0. 초록(Abstract, 연구요약)

Hypothesis Testing(가설검증)은 연구자가 기대한 결과를 확인하는 절차가 아니다.
Data(자료)가 사전에 설정한 Hypothesis(가설)와 어느 정도 일치하는지를 통계적으로 평가하는 과정이다.
가설검증에서는 일반적으로 다음 요소를 함께 살펴본다.
Null Hypothesis(귀무가설)
Alternative Hypothesis(대립가설)
Test Statistic(검정통계량)
p-value(유의확률)
Significance Level(유의수준)
Confidence Interval(신뢰구간)
Effect Size(효과크기)
Coefficient(계수)
그러나 가장 중요한 것은 해석이다.
p<0.05
라고 해서,
가설이 95% 확률로 참이라는 뜻이 아니다.
p≥0.05
라고 해서,
귀무가설이 참으로 입증되었다는 뜻도 아니다.
보다 적절한 표현은 다음과 같다.
p<α → 귀무가설을 기각할 통계적 근거가 있다.
p≥α → 귀무가설을 기각할 충분한 통계적 근거를 확인하지 못했다.
NIST는 Hypothesis Test(가설검정)와 Confidence Interval(신뢰구간)이 서로 밀접하게 대응하며, 양측검정의 경우 가설의 기준값이 해당 신뢰구간 안에 포함되는지 여부와 검정결과를 연결하여 해석할 수 있음을 설명한다.
제14부의 핵심 흐름은 다음과 같다.
Hypothesis(가설)
→ Statistical Test(통계검정)
→ Coefficient(계수)
→ p-value(유의확률)
→ Confidence Interval(신뢰구간)
→ Effect Size(효과크기)
→ Practical Interpretation(실무적 해석)
→ Findings(연구결과)
좋은 연구는 통계적으로 유의한 결과만 찾는 연구가 아니다.
예상과 다른 결과도 정확하게 보고하고 그 의미를 설명하는 연구가 좋은 연구이다.
용어정리
| 한글(한자) | 영어원음(IPA) | 뜻 및 연구·부동산 실무에서의 의미 |
|---|---|---|
| 가설검증 (假說檢證) |
Hypothesis Testing /haɪˈpɑːθəsɪs ˈtestɪŋ/ |
자료를 이용하여 연구가설과 통계적 증거의 관계를 평가하는 과정 |
| 귀무가설 (歸無假說) |
Null Hypothesis /nʌl haɪˈpɑːθəsɪs/ |
차이·관계가 없다는 기준가설 |
| 대립가설 (對立假說) |
Alternative Hypothesis /ɔːlˈtɜːrnətɪv haɪˈpɑːθəsɪs/ |
연구자가 검토하려는 차이·관계가 존재한다는 가설 |
| 검정통계량 (檢定統計量) |
Test Statistic /test stəˈtɪstɪk/ |
표본자료를 이용해 가설을 판단하기 위해 계산하는 통계량 |
| 유의수준 (有意水準) |
Significance Level /sɪɡˈnɪfɪkəns ˈlevəl/ |
귀무가설 기각 기준으로 사전에 설정하는 α 수준 |
| 유의확률 (有意確率) |
p-value /ˈpiː ˌvæljuː/ |
귀무가설이 주어졌을 때 관찰결과와 같거나 더 극단적인 결과가 나타날 정도를 나타내는 값 |
| 신뢰구간 (信賴區間) |
Confidence Interval /ˈkɑːnfɪdəns ˈɪntərvəl/ |
추정값의 불확실성을 범위로 표현하는 방법 |
| 효과크기 (效果크기) |
Effect Size /ɪˈfekt saɪz/ |
변수 사이의 차이·관계가 실제로 어느 정도 큰지를 나타냄 |
| 회귀계수 (回歸係數) |
Regression Coefficient /rɪˈɡreʃən ˌkoʊəˈfɪʃənt/ |
다른 조건을 고려했을 때 설명변수와 종속변수 관계의 방향과 크기 |
| 표준오차 (標準誤差) |
Standard Error /ˈstændərd ˈerər/ |
추정량의 표본 간 변동성을 나타내는 지표 |
| 제1종 오류 (第一種誤謬) |
Type I Error /taɪp wʌn ˈerər/ |
실제로 귀무가설이 참인데 잘못 기각하는 오류 |
| 제2종 오류 (第二種誤謬) |
Type II Error /taɪp tuː ˈerər/ |
실제 차이나 관계가 있는데 이를 발견하지 못하는 오류 |
| 검정력 (檢定力) |
Statistical Power /stəˈtɪstɪkəl ˈpaʊər/ |
실제 효과가 있을 때 이를 통계적으로 발견할 가능성 |
| 통계적 유의성 (統計的有意性) |
Statistical Significance /stəˈtɪstɪkəl sɪɡˈnɪfɪkəns/ |
설정한 유의수준에서 우연만으로 설명하기 어렵다고 판단되는 정도 |
| 연구결과 (硏究結果) |
Research Findings /rɪˈsɜːrtʃ ˈfaɪndɪŋz/ |
분석된 통계결과를 연구질문과 연결하여 정리한 결과 |
H2. 1. 서론(Introduction)
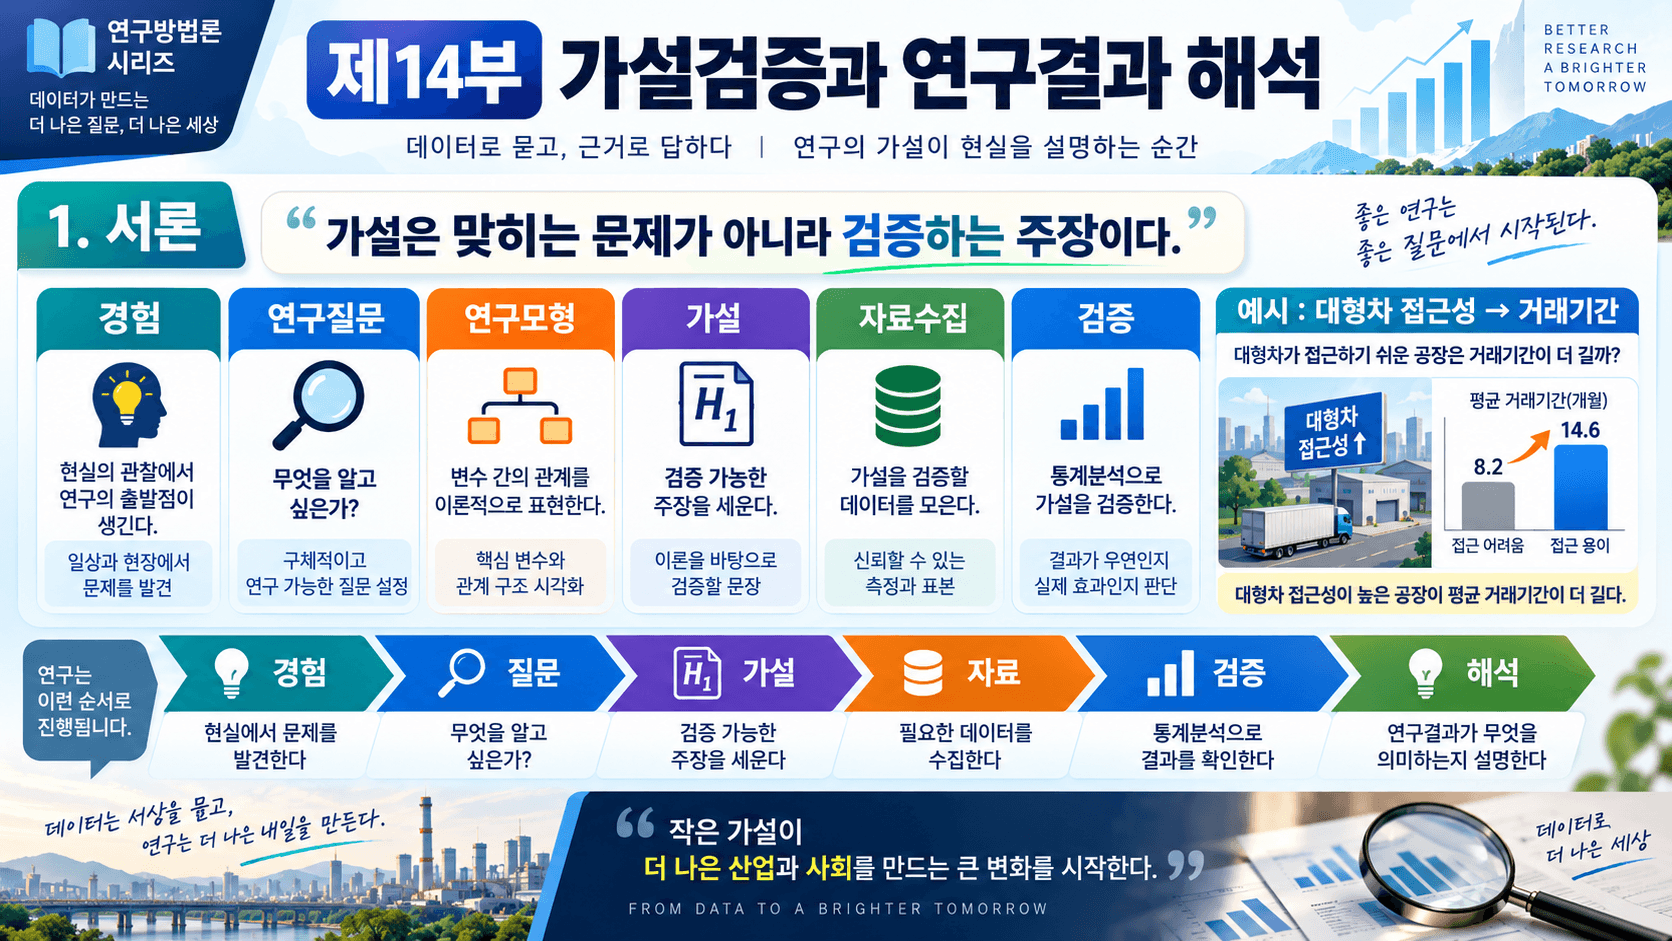
연구자가 통계프로그램에서 가장 먼저 찾는 숫자는 흔히 p-value(유의확률)이다.
p = 0.032
라는 숫자가 나오면 안심하고,
p = 0.071
이라는 숫자가 나오면 연구가 잘못되었다고 생각하기 쉽다.
그러나 이러한 태도는 위험하다.
연구의 목적은 p<0.05를 만드는 것이 아니다.
연구의 목적은 Research Question(연구질문)에 가능한 한 정확하게 답하는 것이다.
예를 들어,
“IC 접근거리는 산업용 토지가격과 관련이 있는가?”
라는 연구질문이 있다고 하자.
다음 결과가 나왔다고 가정한다.
β = -0.02
p = 0.001
표본수 = 100,000
통계적으로는 매우 유의할 수 있다.
그러나 IC 거리가 1km 증가할 때 가격차이가 실무적으로 거의 의미가 없는 수준이라면 기업의 입지선정이나 투자판단에서 중요하지 않을 수 있다.
반대로,
β = -0.20
p = 0.06
표본수가 매우 적은 연구라면 통계적으로 전통적인 5% 기준에 도달하지 못했더라도 관계의 방향과 효과크기, 신뢰구간을 검토할 가치가 있을 수 있다.
따라서 Research Findings(연구결과)는 다음을 함께 봐야 한다.
Direction(방향) → +인가, -인가?
Magnitude(크기) → 관계가 얼마나 큰가?
Uncertainty(불확실성)
→ 신뢰구간은 얼마나 넓은가?
Statistical Evidence(통계적 근거) → p-value는 어떠한가?
Practical Importance(실무적 중요성) → 현실에서 중요한가?
Study Design(연구설계) → 인과해석이 가능한가?
즉 통계결과는 하나의 숫자가 아니라 여러 증거를 종합하여 해석해야 한다.
H2. 2. 이론적 배경(Literature Review, 선행연구 검토)
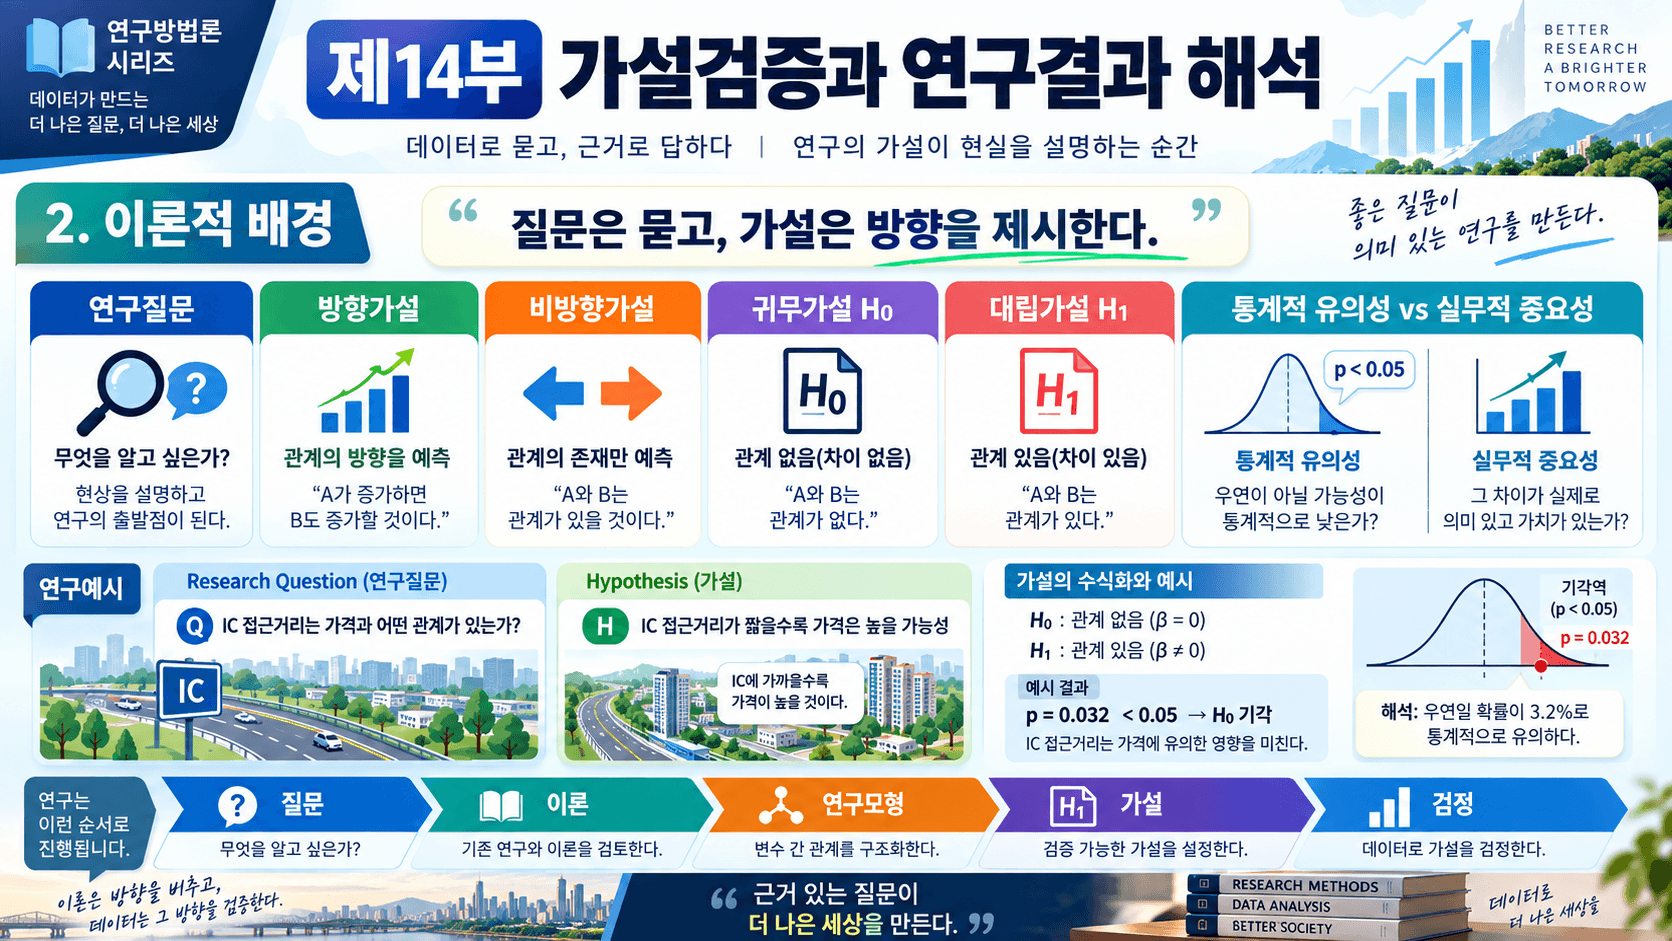
2.1 Null Hypothesis(귀무가설)와 Alternative Hypothesis(대립가설)
예를 들어 다음 Research Hypothesis(연구가설)가 있다고 하자.
H1.
IC 접근거리가 짧을수록 산업용 토지 실거래가격은 높을 가능성이 있다.
통계적 검정에서는 이를 다음처럼 표현할 수 있다.
H₀: β₁ = 0
H₁: β₁ ≠ 0
또는 이론적으로 방향성이 충분히 설정된 연구에서는 연구설계에 따라 방향가설을 고려할 수 있다.
H₀
→ IC 접근거리와 가격 사이에 통계적 관계가 없다는 기준
H₁
→ IC 접근거리와 가격 사이에 통계적 관계가 존재한다는 대안
중요한 점은 가설검정의 목적이 연구자가 원하는 가설을 “증명”하는 데 있지 않다는 것이다.
2.2 Significance Level(유의수준) α
연구에서는 흔히,
α = 0.05 를 사용한다.
이는 귀무가설이 참일 때 잘못 기각하는 Type I Error(제1종 오류)의 허용기준과 관련된다.
NIST는 α=0.05가 일반적으로 널리 사용되는 값임을 설명하지만, 모든 연구에서 반드시 0.05만 사용해야 하는 것은 아니다. 연구의 목적과 오류비용에 따라 기준은 연구설계 단계에서 판단해야 한다.
따라서 유의수준은 결과를 본 뒤 바꾸는 것이 아니라 가능하면 분석 전에 정한다.
2.3 p-value(유의확률)를 올바르게 읽는다
p-value는,
“귀무가설이 참일 확률”
이 아니다.
또한,
p = 0.03
이라고 해서,
“연구가설이 97% 확률로 참이다.”
라는 뜻도 아니다.
p-value는 귀무가설과 통계모형의 조건을 전제로 했을 때 현재 관찰값과 같거나 더 극단적인 자료가 나타나는 정도를 나타내는 지표이다.
따라서,
p = 0.049
와
p = 0.051
을 완전히 다른 세계처럼 해석하는 것은 적절하지 않다.
두 결과는 통계적으로 매우 비슷한 증거일 수 있다.
2.4 “귀무가설을 채택한다”는 표현을 조심한다
p≥0.05일 때 흔히,
“귀무가설을 채택하였다.”
라고 쓰기도 한다.
그러나 보다 신중한 표현은,
“귀무가설을 기각할 충분한 통계적 근거를 확인하지 못하였다.”
이다.
왜냐하면 유의하지 않은 결과는,
실제 관계가 없음
뿐 아니라,
표본 부족
높은 측정오차
효과가 작음
자료의 변동성이 큼
분석모형의 부적합
등 여러 이유로 발생할 수 있기 때문이다.
따라서,
Not Significant(통계적으로 유의하지 않음)
≠ No Effect(효과가 전혀 없음)
이다.
2.5 Confidence Interval(신뢰구간)은 추정의 불확실성을 보여준다
신뢰구간은 하나의 추정값만 제시하는 것보다 결과의 불확실성을 더 잘 보여준다.
예를 들어,
β = -0.12
95% CI = -0.18 ~ -0.06
라고 하자.
계수는 음(-)의 방향이고 신뢰구간 전체가 0보다 작다.
반대로,
β = -0.12
95% CI = -0.30 ~ 0.06
이라면 추정값 자체는 음(-)이지만 불확실성 범위에 0이 포함된다.
NIST는 Confidence Interval(신뢰구간)이 표본통계가 모집단의 값을 어느 정도 정밀하게 추정하는지를 범위로 보여주며, 반복표본 관점에서 설정된 신뢰수준을 해석해야 한다고 설명한다.
2.6 Effect Size(효과크기)는 “얼마나 큰가?”에 답한다
통계적 유의성은 관계가 존재한다는 증거와 관련되지만 Effect Size(효과크기)는 그 관계가 얼마나 큰지를 보여준다.
예를 들어,
A지역 평균 가격 = 100만원/㎡
B지역 평균 가격 = 101만원/㎡
표본이 매우 크면 1만원 차이도 통계적으로 유의할 수 있다.
하지만 투자자 입장에서는 1% 차이가 중요하지 않을 수도 있다.
반대로,
가격차이 = 30만원/㎡
인데 표본수가 적어 p=0.07이라면 실무적으로 주목할 가치가 있을 수 있다.
따라서,
Statistical Significance(통계적 유의성)
Effect Size(효과크기)
Confidence Interval(신뢰구간)
Practical Meaning(실무적 의미)
을 함께 봐야 한다.
2.7 Type I Error(제1종 오류)와 Type II Error(제2종 오류)
Type I Error(제1종 오류)
→ 실제 관계가 없는데 있다고 판단
Type II Error(제2종 오류)
→ 실제 관계가 있는데 없다고 판단
예를 들어 기업이 신규 물류센터 후보지를 평가하는 연구에서 실제로 IC 접근성이 공실률에 중요하지 않은데 중요하다고 판단하면 제1종 오류와 연결될 수 있다.
반대로 실제로 중요한 입지조건인데 연구표본이 부족해 관계를 발견하지 못한다면 제2종 오류와 연결될 수 있다.
연구에서는 두 오류를 함께 생각해야 한다.
2.8 Statistical Power(검정력)
Statistical Power(검정력)는 실제 효과가 존재할 때 이를 발견할 가능성과 관련된다.
검정력은 일반적으로 다음과 관련된다.
표본수
효과크기
자료의 변동성
측정정확도
설정한 α
따라서 유의하지 않은 결과가 나왔다고 즉시,
“관계가 없다.”
라고 결론내리지 말고 연구가 충분한 검정력을 갖고 있었는지도 생각해야 한다.
H2. 3. 관계 법령 및 제도 분석

3.1 통계결과를 선택적으로 보고하지 않는다
연구자가 기대한 가설만 보고하고 유의하지 않은 가설을 삭제하면 연구결과의 신뢰성이 낮아질 수 있다.
예를 들어 사전에 H1~H5를 설정했다면,
H1 채택
H2 기각
H3 기각
H4 채택
H5 기각
처럼 실제 결과를 모두 공개하는 것이 연구의 투명성을 높인다.
가설이 지지되지 않았다고 해서 연구가 실패한 것은 아니다.
3.2 결과를 본 뒤 가설을 처음부터 있었던 것처럼 바꾸지 않는다
분석 후 새로운 관계를 발견할 수 있다.
그 자체는 중요한 연구발견일 수 있다.
그러나 분석 이후 발견한 관계를 처음부터 설정했던 가설처럼 기술하면 연구의 투명성이 약해질 수 있다.
따라서,
Confirmatory Analysis(확증적 분석)
→ 사전 설정한 가설 검증
Exploratory Analysis(탐색적 분석)
→ 데이터 분석과정에서 새롭게 발견한 관계
로 구분하여 제시한다.
3.3 연구윤리는 숫자 조작뿐 아니라 해석에도 적용된다
연구부정은 데이터를 직접 변조하는 경우에만 발생하는 것이 아니다.
다음과 같은 행동도 주의해야 한다.
원하는 결과가 나올 때까지 분석방법 변경
특정 표본을 이유 없이 제거
불리한 결과를 보고하지 않음
통계적으로 유의한 결과만 선택
p-value만 강조하고 효과크기를 숨김
상관관계를 인과관계로 과장
따라서 연구자는 분석과 해석과정을 기록해야 한다.
3.4 AI가 만든 통계해석도 최종 검증이 필요하다
AI는 통계결과 설명을 도와줄 수 있다.
예를 들어,
회귀표 설명
가설검정 문장 작성
신뢰구간 해석
표 제목 작성
결과 요약
등에 활용할 수 있다.
그러나 AI가,
β의 방향을 잘못 읽거나,
p-value를 확률로 오해하거나,
통계적 관계를 인과관계로 과장할 가능성이 있다.
따라서 최종 Research Findings(연구결과)는 연구자가 직접 확인해야 한다.
H2. 4. 핵심 이론 분석
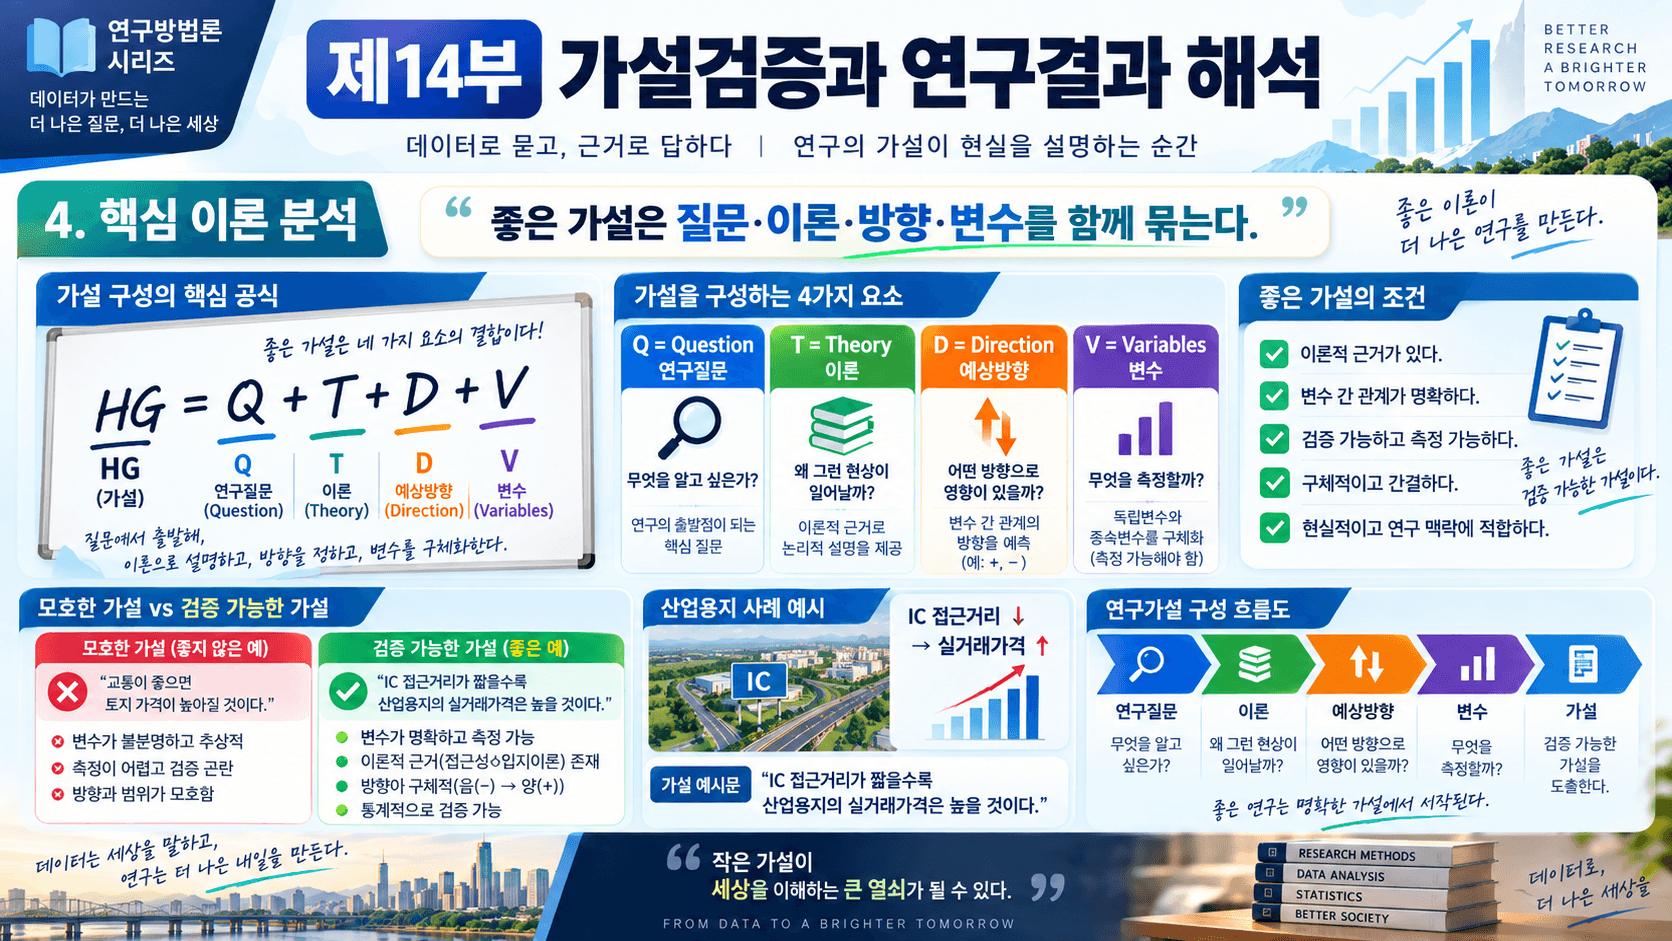
4.1 Hypothesis Interpretation(가설해석)의 핵심 구조식
제14부에서는 결과해석을 쉽게 기억하기 위해 다음 학습용 구조식을 사용한다.
HI = D + M + U + P
HI = Hypothesis Interpretation(가설해석)
D = Direction(방향)
→ 관계가 +인가, -인가?
M = Magnitude(크기)
→ 관계가 어느 정도 큰가?
U = Uncertainty(불확실성)
→ 신뢰구간과 표준오차는 어떠한가?
P = Practical Meaning(실무적 의미)
→ 현실적으로 중요한가?
따라서,
HI = D + M + U + P
를 우리말로 풀면,
가설해석 = 방향 + 크기 + 불확실성 + 실무적 의미
이다.
4.2 p-value는 판단의 한 요소이다
가령 다음 결과가 있다고 하자.
β = -0.150
p = 0.012
95% CI = -0.265 ~ -0.035
연구자는 다음 순서로 읽을 수 있다.
첫째,
β<0
→ 변수 사이의 관계 방향은 음(-)이다.
둘째,
p<0.05
→ 설정한 유의수준에서 귀무가설을 기각할 통계적 근거가 있다.
셋째,
신뢰구간이 0을 포함하지 않는다.
→ 해당 양측검정과 일관된 결과이다.
넷째,
β=-0.150이 실무적으로 얼마나 큰지 확인한다.
NIST는 양측검정에서 신뢰구간과 가설검정 사이에 대응관계가 있음을 설명한다.
4.3 p≥0.05의 결과를 버리지 않는다
예를 들어,
β = -0.10
p = 0.08
라고 하자.
적절한 표현은 다음과 같다.
“IC 접근거리의 회귀계수는 음(-)의 방향으로 나타났으나 설정한 5% 유의수준에서는 통계적으로 유의한 관계가 확인되지 않았다.”
좋지 않은 표현은 다음과 같다.
“IC 접근거리는 가격과 관계가 없다.”
후자의 표현은 너무 강하다.
4.4 회귀계수는 단위와 함께 해석한다
다음 모형을 생각해 보자.
PRICE = β₀ + β₁ICDIST + ε
PRICE
→ 원/㎡
ICDIST
→ km
β₁=-20,000
이라고 가정하면,
다른 조건을 고려하지 않은 단순모형에서는 IC 거리가 1km 증가할 때 가격이 평균적으로 ㎡당 20,000원 낮은 방향과 관련되어 있다는 의미가 된다.
하지만 실제 연구에서는 다른 변수, 모형의 형태, 로그변환 여부에 따라 해석방법이 달라진다.
4.5 로그모형에서는 계수해석이 달라진다
예를 들어,
ln(PRICE) = β₀ + β₁ICDIST + ε
에서
β₁ = -0.05
라면 작은 계수에서 근사적으로 IC 거리가 1km 증가할 때 가격이 약 5% 낮아지는 방향과 연결된다고 해석할 수 있다.
보다 정확한 변화율은,
100 × [exp(β) − 1]
을 사용할 수 있다.
β=-0.05라면,
exp(-0.05) ≈ 0.951
따라서,
약 -4.9%
정도로 해석할 수 있다.
이 공식의 목적은 로그종속변수의 계수를 실제 비율 변화에 가깝게 바꾸는 것이다.
4.6 Confidence Interval(신뢰구간)의 폭도 중요하다
다음 두 연구를 비교해 보자.
연구 A
β = -0.10
95% CI = -0.12 ~ -0.08
연구 B
β = -0.10
95% CI = -0.40 ~ 0.20
두 연구의 점추정치는 동일하다.
하지만 연구 A의 추정은 훨씬 정밀하다.
연구 B는 불확실성이 매우 크다.
따라서 계수만 보고 연구결과를 판단하면 안 된다.
4.7 Effect Size(효과크기)를 실무언어로 바꾼다
예를 들어 기업 후보지 분석에서 IC 접근성 점수가 1단계 개선될 때 평균 물류비가 월 100만원 감소한다고 하자.
대형 기업에는 미미한 차이일 수 있다.
그러나 소규모 기업에는 중요한 차이일 수 있다.
따라서 동일한 효과크기도 연구대상과 의사결정 상황에 따라 실무적 의미가 다를 수 있다.
4.8 Research Findings(연구결과)는 사실과 해석을 구분한다
좋은 결과 작성은 다음과 같이 나눌 수 있다.
첫째, 통계적 사실.
“IC 거리의 회귀계수는 -0.12였으며 p=0.03으로 나타났다.”
둘째, 해석.
“이는 다른 포함 변수를 고려했을 때 IC 접근거리가 증가할수록 실거래가격이 낮아지는 방향의 관계가 관찰되었음을 의미한다.”
셋째, 한계.
“다만 관찰자료이므로 이 결과만으로 직접적인 인과관계를 단정하기 어렵다.”
이 세 단계가 분리되어야 한다.
H2. 5. 실무 사례 연구(Case Study)

공인중개사 30년 실무 노트 (Real Estate Insights & Consulting)
안녕하세요. 엑스포공인중개사사무소 대표 조상현입니다.
경기도 광주시 곤지암읍, 도척면, 초월읍 등 수도권 공업·물류 및 주거용 부동산 거래의 최전선에서 30년간 현장을 발로 뛰며 체득한 실무 데이터와 노하우를 기록하는 ‘공인중개사 30년 실무 노트’입니다.
현장에서 수많은 계약과 협상을 마주하다 보면, 거래의 성패는 결국 ‘공적 장부와 법적 권리관계를 얼마나 입체적이고 꼼꼼하게 꿰뚫어 보느냐’에 달려 있음을 매 순간 절감하게 됩니다. 조선시대 실학자 이중환이 『택리지(擇里志)』를 통해 거주의 조건을 철저히 따져보았듯, 현대 거래 역시 겉으로 보이는 개발 호재나 화려한 조건에 현혹되지 않고 등기부등본의 표제부, 갑구, 을구, 그리고 각종 공적 규제를 완벽하게 해독하는 정밀한 분석에서 안전이 시작됩니다.
컴퓨터공학적 데이터 분석 마인드, 부동산학·경영학적 이론, 그리고 30년간 현장에서 축적한 생생한 자문 경험을 결합하여, 독자 여러분께 가장 정확하고 실효성 있는 실무 가이드를 제공합니다. 수백 년 전 선조들이 입지를 가려내듯 철저한 공적 장부 검증과 세심한 특약 설계로 안전하고 성공적인 자산 운용의 나침반이 되어 드리겠습니다.
[산업용 부동산 연구방법론: 가설검증(Hypothesis Testing)과 연구결과 해석을 다루는 사례 연구 4가지]
사례 1. 산업용 토지의 IC 접근성과 실거래가격 가설검증의 전개
“IC가 가까울수록 토지 실거래가격이 높을 것이다”라는 가설을 다중회귀분석을 통해 검증한 결과, 회귀계수(beta)는 -0.08, p값은 0.018, 95% 신뢰구간은 -0.14에서 -0.01 사이로 나타나 5% 유의수준에서 귀무가설을 기각했습니다. IC 접근거리가 증가할수록(즉, 거리가 멀어질수록) 가격이 낮아지는 통계적 관계를 확인했으나, 이를 곧바로 “IC가 가격을 떨어뜨린다”는 직접적 인과관계로 단정하지 않고 지역 효과와 토지특성을 함께 고려하여 기업 입지 및 가격 평가에 활용합니다.
1) Research Question(연구질문)
IC 접근거리는 산업용 토지 실거래가격과 어떤 관계가 있는가?
2) Hypothesis(가설)
H1.
IC 접근거리가 짧을수록 산업용 토지 실거래가격은 높을 가능성이 있다.
3) 가상 분석결과
β = -0.08
p = 0.018
95% CI = -0.14 ~ -0.01
4) 가설판단
5% 유의수준에서 귀무가설을 기각할 통계적 근거가 있다고 해석할 수 있다.
5) 방향
β<0
→ IC 접근거리가 증가할수록 가격은 낮아지는 방향이다.
6) Confidence Interval(신뢰구간)
신뢰구간이 0을 포함하지 않는 가상결과이다.
7) 예상 연구결과 문장
“다른 토지특성을 통제한 후에도 IC 접근거리는 산업용 토지 실거래가격과 음(-)의 통계적 관계를 보였다.”
8) 주의점
이를,
“IC가 가격을 떨어뜨린다.”
라고 바로 인과적으로 표현하지 않는다.
9) 추가검토
도로 폭
용도지역
토지면적
지역효과
공간적 자기상관
등을 고려한다.
10) 실무활용
기업입지
토지매입
산업용 부지 가격평가
개발타당성
등에 활용할 수 있다.
사례 2. 공장의 대형차 접근성과 거래기간 가설검증의 전개
대형차 진입이 가능한 공장이 더 빠르게 거래될 것이라는 가설을 콕스 비례위험모형(Cox Proportional Hazards Model)으로 검증한 결과, 거래완료 이벤트에 대한 위험비(Hazard Ratio)가 1.35 (p = 0.031, 95% 신뢰구간 1.03 ~ 1.77)로 확인되었습니다. 이는 대형차 진입이 가능한 공장이 그렇지 않은 공장에 비해 거래발생률이 상대적으로 높아 유동성이 우수함을 시사하며, 공장 매각 전략 수립과 장기 매물 진단에 실무적인 지표로 활용됩니다.
1) Research Question(연구질문)
대형차 접근성이 좋은 공장은 더 빠르게 거래되는가?
2) Hypothesis(가설)
H1.
대형차 접근성이 가능한 공장은 거래완료 가능성이 더 높을 수 있다.
3) 가상 Cox 결과
Hazard Ratio(위험비) = 1.35
p = 0.031
95% CI = 1.03 ~ 1.77
4) Hazard Ratio(위험비) 해석
이 연구의 Event(사건)는 “거래완료”이다.
따라서 HR>1은 거래발생 속도가 더 빠른 방향과 연결될 수 있다.
5) 가설판단
통계적으로 유의한 관계가 확인되었다고 해석할 수 있다.
6) 실무적 의미
대형차 진입 가능성이 공장의 유동성과 거래성에 중요한 입지조건일 가능성을 시사할 수 있다.
7) 주의점
가격
건축연도
면적
전력
IC 거리
지역시장
등 다른 요인을 함께 고려해야 한다.
8) 가상 결과문장
“대형차 진입이 가능한 공장은 다른 조건을 고려한 이후에도 거래완료 Hazard(발생률)가 상대적으로 높은 것으로 나타났다.”
9) 인과해석 주의
관찰자료라면 대형차 접근성만이 거래기간의 직접적 원인이라고 단정하기 어렵다.
10) 활용
공장 매각전략
장기매물 진단
기업 이전
신규 공장 후보지 평가
등에 활용할 수 있다.
사례 3. 물류창고 시설조건과 공실률 가설검증의 전개
물류창고의 입지·시설조건과 공실률의 관계를 검증한 가상 분석에서 IC 접근거리 계수는 0.09 (p = 0.041)로 유의한 양의 관계를 보인 반면, 층고 계수는 -0.07 (p = 0.11)로 예상했던 음의 방향을 보였으나 본 표본에서는 통계적으로 유의하지 않은 결과가 도출되었습니다. 이를 “층고가 관계없다”고 속단하지 않고, 표본수와 층고 분포 등의 한계를 고려하여 신중하게 해석하며 물류센터 개발과 공실위험 관리 전략에 반영합니다.
1) Research Question(연구질문)
IC 접근성·층고·도크조건은 물류창고 공실률과 관련되는가?
2) Hypothesis(가설)
H1.
입지와 시설조건이 우수할수록 공실률은 낮을 가능성이 있다.
3) 가상 결과
IC 거리 계수
β = 0.09
p = 0.041
층고 계수
β = -0.07
p = 0.11
4) IC 거리 해석
거리계수가 양(+)이라면 IC에서 멀어질수록 공실률이 높아지는 방향일 수 있다.
5) 층고 해석
계수는 예상한 음(-)의 방향이지만 5% 수준에서는 통계적으로 유의하지 않을 수 있다.
6) 잘못된 결론
“층고는 공실률과 관계가 없다.”
7) 더 적절한 결론
“층고는 공실률과 음(-)의 방향을 보였으나 본 표본에서는 통계적으로 충분한 근거가 확인되지 않았다.”
8) 추가검토
표본수
층고 분포
지역별 시장차이
신규공급량
임대료
건축연도
를 검토한다.
9) 실무적 의미
예상과 일치하지 않는 결과도 개발사업과 임대전략에서 중요한 정보가 될 수 있다.
10) 활용
창고매입
물류센터 개발
공실위험 관리
시설 개선 투자
등에 활용할 수 있다.
사례 4. 공인중개사의 전문성·고객신뢰·계약의사 가설검증의 전개
공인중개사의 전문성이 고객신뢰를 거쳐 계약의사로 연결되는 매개모형을 검증한 결과, 전문성에서 신뢰로 가는 직접경로 계수가 0.42 (p < 0.001), 신뢰에서 계약의사로 가는 경로가 0.31 (p = 0.004)로 나타났습니다. 이 두 경로를 곱한 간접효과(a 곱하기 b는 약 0.13)를 통해 전문성이 고객신뢰라는 심리적 경로를 매개로 계약의사와 단단하게 연결됨을 확인하였으며, 이를 통해 중개서비스 품질 관리와 고객관계관리(CRM) 전략의 학술적·실무적 근거를 확립합니다.
1) Research Model(연구모형)
Professionalism(전문성)
→ Trust(고객신뢰)
→ Contract Intention(계약의사)
2) Hypothesis(가설)
H1.
전문성은 고객신뢰와 정(+)의 관계를 가질 가능성이 있다.
H2.
고객신뢰는 계약의사와 정(+)의 관계를 가질 가능성이 있다.
H3.
고객신뢰는 전문성과 계약의사 사이를 매개할 가능성이 있다.
3) 가상 직접경로
전문성 → 신뢰
β = 0.42
p<0.001
4) 가상 두 번째 경로
신뢰 → 계약의사
β = 0.31
p = 0.004
5) Indirect Effect(간접효과)
간접효과 = a × b
예를 들어,
a=0.42
b=0.31
이면,
a×b ≈ 0.13
이다.
이 값은 전문성이 고객신뢰를 거쳐 계약의사와 연결되는 간접경로의 크기를 나타내는 교육용 예시이다.
6) Bootstrap Confidence Interval(부트스트랩 신뢰구간)
간접효과 검증에서는 Bootstrap(부트스트랩)을 이용한 신뢰구간을 검토할 수 있다.
7) 연구결과 문장
“전문성은 고객신뢰와 정(+)의 관계를 보였으며, 고객신뢰는 계약의사와 정(+)의 관계를 나타냈다.”
8) 주의점
횡단면 설문자료라면 시간순서와 인과관계를 강하게 주장하지 않는다.
9) 실무적 의미
전문성 향상은 단순한 지식증가가 아니라 고객신뢰 형성을 통해 중개서비스의 가치와 연결될 가능성을 시사한다.
10) 활용
공인중개사 교육
서비스 품질관리
고객관리
브랜드 전략
등에 활용할 수 있다.
사례별 Hypothesis Testing(가설검증) 프레임
| 사례 | 핵심 결과 | 주요 통계값 | 해석 포인트 | 주의점 |
|---|---|---|---|---|
| 산업용 토지 | 가격관계 | β·p·CI | 방향·가격효과 | 인과추론 주의 |
| 공장 | 거래속도 | Hazard Ratio·p·CI | 사건발생률 | Event 정의 |
| 물류창고 | 공실률 | β·p·CI | 방향·비율효과 | 비유의 결과도 보고 |
| 중개서비스 | 매개효과 | β·간접효과·CI | 직접·간접경로 | 횡단면 인과해석 |
네 사례에서 공통적으로 적용되는 흐름은 다음과 같다.
Hypothesis(가설)
→ Estimate(추정치)
→ Direction(방향)
→ Magnitude(크기)
→ p-value(유의확률)
→ Confidence Interval(신뢰구간)
→ Practical Meaning(실무적 의미)
→ Findings(연구결과)
H2. 6. 실무 체크리스트(Practical Checklist, 실무 점검표)
□ 연구가설을 분석 전에 설정했는가?
□ Null Hypothesis(귀무가설)와 Alternative Hypothesis(대립가설)를 구분했는가?
□ Significance Level(유의수준)을 사전에 정했는가?
□ 회귀계수의 방향을 확인했는가?
□ 계수의 단위를 이해하고 있는가?
□ p-value(유의확률)를 가설이 참일 확률로 해석하지 않는가?
□ p≥0.05일 때 “귀무가설이 참”이라고 단정하지 않는가?
□ 비유의 결과도 그대로 보고하는가?
□ Confidence Interval(신뢰구간)을 확인했는가?
□ 신뢰구간의 폭을 확인했는가?
□ Effect Size(효과크기)를 검토했는가?
□ Statistical Significance(통계적 유의성)와 Practical Significance(실무적 중요성)를 구분했는가?
□ 결과가 예상방향과 일치하는가?
□ 예상과 반대 결과도 그대로 기록했는가?
□ 분석 후 가설을 임의로 변경하지 않았는가?
□ Confirmatory Analysis(확증적 분석)와 Exploratory Analysis(탐색적 분석)를 구분했는가?
□ 인과관계를 주장할 수 있는 연구설계인가?
□ 누락변수 가능성을 검토했는가?
□ 표본크기가 충분한가?
□ Statistical Power(검정력)를 고려했는가?
□ 여러 가설을 동시에 검정하는 경우 다중비교 문제를 고려했는가?
□ 표와 본문의 수치가 일치하는가?
□ 소수점 자릿수가 일관되는가?
□ AI가 작성한 해석을 원결과와 대조했는가?
□ 실무적으로 중요한 결과인지 설명했는가?
H2. 7. 자주 묻는 질문(FAQ, Frequently Asked Questions)
Q1. p<0.05이면 가설이 참입니까?
아니다. 설정한 통계모형과 귀무가설 아래에서 해당 결과가 어느 정도 이례적인지를 보여주는 지표이지 연구가설이 참일 확률을 의미하지 않는다.
Q2. p=0.051이면 아무 의미가 없습니까?
그렇게 단정하면 안 된다. p-value, 효과크기, 신뢰구간, 표본크기와 연구설계를 함께 살펴야 한다.
Q3. p>0.05이면 귀무가설을 채택합니까?
보다 신중하게는 “귀무가설을 기각할 충분한 통계적 근거를 확인하지 못했다”고 표현하는 것이 좋다.
Q4. 신뢰구간은 왜 봐야 합니까?
점추정치 하나만으로 알기 어려운 추정의 불확실성과 정밀도를 보여주기 때문이다.
Q5. 통계적으로 유의하면 실무적으로도 중요합니까?
아니다. 매우 작은 효과도 표본수가 크면 통계적으로 유의할 수 있다. 효과크기와 현실적인 중요성을 함께 평가해야 한다.
Q6. 가설이 기각되면 연구가 실패한 것입니까?
아니다. 연구자의 예상과 다른 결과 역시 중요한 연구결과이다.
Q7. 예상과 반대방향의 결과가 나오면 어떻게 합니까?
그대로 보고하고 선행연구, 연구대상, 측정방법, 시장상황 등을 바탕으로 가능한 이유를 Discussion(논의)에서 검토한다.
Q8. 회귀계수가 크면 무조건 중요한 변수입니까?
변수의 단위와 표준화 여부가 다르면 단순한 숫자 크기만 비교하기 어렵다. 실질적 변화량을 함께 해석해야 한다.
Q9. AI로 결과문장을 작성해도 됩니까?
초안작성은 가능하지만 수치, 방향, p-value, 신뢰구간과 인과해석은 연구자가 직접 검증해야 한다.
Q10. 가설검증 다음 단계는 무엇입니까?
제15부에서는 Research Findings(연구결과)를 선행연구 및 Theory(이론)와 연결하여 Discussion(논의), Academic Contribution(학술적 기여), Practical Contribution(실무적 기여)로 발전시키는 방법을 살펴본다.
H2. 8. 연구자의 실무 의견(Author’s Insight, 연구자의 실무적 견해)
공인중개사 30년 실무에서는 끊임없이 가설을 세우고 검증한다.
“IC가 가까우면 가격이 높을 것이다.”
“도로가 넓으면 공장 거래가 빠를 것이다.”
“전력이 충분하면 기업 선호도가 높을 것이다.”
“층고가 높으면 창고 공실이 적을 것이다.”
“전문성이 높으면 고객이 신뢰할 것이다.”
이러한 판단은 실무에서 매우 중요하다.
그러나 경험이 항상 맞는 것은 아니다.
특정 지역에서는 IC보다 토지가격이 더 중요할 수 있다.
대형차 접근성보다 전력용량이 거래속도에 더 큰 영향을 줄 수도 있다.
물류창고의 경우 층고보다 임대료가 공실에 더 중요한 시기가 있을 수도 있다.
따라서 실무경험은 연구의 출발점이지 연구의 최종결론은 아니다.
Experience(경험)
→ Hypothesis(가설)
→ Measurement(측정)
→ Data(자료)
→ Statistical Analysis(통계분석)
→ Hypothesis Testing(가설검증)
→ Findings(연구결과)
→ Practical Knowledge(실무지식)
로 발전해야 한다.
특히 연구자의 경험과 반대되는 결과를 존중해야 한다.
30년 경험에서 중요하다고 생각했던 변수가 통계적으로 유의하지 않을 수도 있다.
그렇다고 데이터를 틀렸다고 먼저 생각할 것이 아니라,
측정기준이 적절했는가?
표본은 충분했는가?
시장상황이 바뀌었는가?
다른 중요한 변수가 있는가?
를 다시 검토해야 한다.
실무자의 강점은 데이터를 무시하는 것이 아니라 데이터와 현장을 함께 읽는 데 있다.
H2. 9. 정책 제언 및 투자 전략(Policy Recommendations & Investment Strategy, 정책·투자 제언)

9.1 정책과 투자에서는 p-value보다 효과크기를 함께 본다
정책과 투자판단에서는 단순히,
“통계적으로 유의하다.”
는 표현보다,
“얼마나 큰 변화가 발생하는가?”
가 중요하다.
예를 들어 새로운 도로개통이 산업용 토지가격에 통계적으로 유의한 영향을 보였다고 하더라도 실제 가격상승폭이 매우 작다면 투자판단은 달라질 수 있다.
따라서 정책보고서와 투자분석에서는,
Coefficient(계수)
Effect Size(효과크기)
Confidence Interval(신뢰구간)
경제적 규모
실제 비용
위험
을 함께 제시하는 것이 바람직하다.
9.2 기업 입지평가는 유의성과 실무효과를 함께 본다
공장 후보지 A·B·C를 비교한다고 하자.
IC 거리
전력용량
토지가격
대형차 접근성
인력접근성
확장가능면적
등을 연구할 수 있다.
통계적으로 IC 거리가 중요하더라도 실제 기업의 물류비 절감효과가 작다면 전력이나 확장성이 더 중요한 의사결정 요소가 될 수 있다.
따라서,
Statistical Evidence(통계적 근거)
Business Impact(경영적 영향)
Site Condition(현장조건)
을 함께 분석해야 한다.
9.3 공공데이터 활용에서도 통계적 의미를 과장하지 않는다
부동산 연구에서는 다음 공식 자료원을 활용할 수 있다.
국토교통부 실거래가 공개시스템
→ 실거래가격·면적·거래시점
한국부동산원 R-ONE
→ 가격·지가·거래·상업용부동산 통계
KOSIS
→ 인구·산업·사업체·지역경제 통계
그러나 큰 데이터라고 자동으로 좋은 연구가 되는 것은 아니다.
표본이 매우 크면 작은 차이도 통계적으로 유의할 수 있기 때문이다.
따라서 공공데이터 분석에서는 실질적인 변화량을 함께 제시해야 한다.
9.4 기업의 부동산 투자판단도 불확실성을 표시한다
기업의 입지평가 보고서에서 하나의 예상가격만 제시하는 것보다,
예상가격 범위
낙관적 시나리오
기준 시나리오
보수적 시나리오
를 함께 제시하면 불확실성을 더 잘 표현할 수 있다.
통계학의 Confidence Interval(신뢰구간) 사고방식은 기업의 위험관리와도 연결할 수 있다.
9.5 “유의하지 않은 결과”도 정책적 가치가 있다
예를 들어 예상과 달리 특정 산업단지에서 IC 접근성이 토지가격과 통계적으로 유의하지 않았다고 하자.
이 결과는 실패가 아니다.
해당 지역에서는,
기업집적
용도지역
공급부족
산업단지 지정
전력
도로
등 다른 조건이 더 중요할 가능성을 제시한다.
비유의 결과도 새로운 연구질문으로 연결된다.
9.6 장기간의 실무기록은 가설검증의 자료가 된다
공인중개사 30년 실무기록이 표준화되면 다음과 같은 가설을 검증할 수 있다.
대형차 접근 가능 공장은 더 빨리 거래되는가?
IC 접근성이 좋은 산업용 토지는 가격이 높은가?
전력용량이 큰 공장은 기업 선호도가 높은가?
도크 수가 많은 창고는 공실률이 낮은가?
중개사의 전문성은 고객신뢰와 관련되는가?
경험이 가설이 되고,
가설이 데이터로 검증되고,
검증된 결과가 다음 세대의 실무지식으로 남는 구조를 만들 수 있다.
H2. 10. 결론(Conclusion, 결론)

제14부의 핵심은 간단하다.
통계분석의 숫자를 그대로 나열하는 것이 Research Findings(연구결과)가 아니다.
숫자가 무엇을 의미하는지를 Research Question(연구질문), Theory(이론), Hypothesis(가설), Data(자료), 실제 현장과 연결해야 한다.
제14부에서 기억해야 할 구조식은 다음과 같다.
HI = D + M + U + P
HI
→ Hypothesis Interpretation(가설해석)
D
→ Direction(방향)
M
→ Magnitude(크기)
U
→ Uncertainty(불확실성)
P
→ Practical Meaning(실무적 의미)
즉,
가설해석 = 방향 + 크기 + 불확실성 + 실무적 의미
이다.
통계결과는 다음 순서로 읽는다.
Coefficient(계수)
→ 방향과 크기
p-value(유의확률)
→ 통계적 근거
Confidence Interval(신뢰구간)
→ 불확실성
Effect Size(효과크기)
→ 관계의 실제 크기
Practical Meaning(실무적 의미)
→ 현실적 가치
Hypothesis Testing(가설검증)에서 반드시 기억해야 할 원칙도 있다.
p<0.05
≠ 연구가설이 95% 확률로 참
p≥0.05
≠ 귀무가설이 참으로 증명됨
Statistical Significance(통계적 유의성)
≠ Practical Significance(실무적 중요성)
Correlation(상관관계)
≠ Causality(인과관계)
Hypothesis Rejection(가설 미지지)
≠ Research Failure(연구 실패)
좋은 연구는 모든 가설이 지지되는 연구가 아니다.
예상과 다른 결과도 그대로 보고하고 그 이유를 탐구하는 연구가 좋은 연구이다.
전체 연구과정은 이제 다음 단계까지 발전하였다.
Research Topic(연구주제)
→ Abstract(초록)
→ Research Problem(연구문제)
→ Literature Review(선행연구 검토)
→ Research Gap(연구공백)
→ Research Question(연구질문)
→ Theory(이론)
→ Variables(변수)
→ Research Model(연구모형)
→ Hypothesis(가설)
→ Measurement(측정)
→ Data Collection(자료수집)
→ Statistical Analysis(통계분석)
→ Hypothesis Testing(가설검증)
→ Findings(연구결과)
→ Discussion(논의)
→ Research Paper(연구논문)
제1부에서는 Research Topic(연구주제)을 찾았다.
제2부에서는 Abstract(초록)를 작성했다.
제3부에서는 Research Problem(연구문제)을 만들었다.
제4부에서는 Literature Review(선행연구 검토)를 정리했다.
제5부에서는 Research Gap(연구공백)을 찾았다.
제6부에서는 Research Question(연구질문)을 구체화했다.
제7부에서는 Theory(이론)를 살펴보았다.
제8부에서는 Variables(변수)를 정의했다.
제9부에서는 Research Model(연구모형)을 만들었다.
제10부에서는 Hypothesis(가설)를 설정했다.
제11부에서는 Measurement(측정)와 Scale(척도)을 설계했다.
제12부에서는 Data Collection(자료수집)·Coding(코딩)·Cleaning(정제)을 통해 Dataset(데이터셋)을 만들었다.
제13부에서는 Statistical Analysis(통계분석)를 수행하는 기본원리를 살펴보았다.
제14부에서는 Regression Coefficient(회귀계수), p-value(유의확률), Confidence Interval(신뢰구간), Effect Size(효과크기)를 통해 Hypothesis(가설)를 판단하고 Research Findings(연구결과)로 작성하는 방법을 살펴보았다.
다음 제15부에서는 이제 한 단계 더 나아가,
“이 결과가 기존 연구와 비교하여 무엇을 의미하는가?”
를 중심으로 Discussion(논의), Academic Contribution(학술적 기여), Practical Contribution(실무적 기여), Research Limitation(연구한계)을 작성하는 방법을 살펴본다.
참고문헌 (References)
- 「NIST/SEMATECH e-Handbook of Statistical Methods ― Confidence Interval Approach」
- Hypothesis Testing(가설검정)과 Confidence Interval(신뢰구간)의 관계, 귀무가설 기각 여부와 신뢰구간 해석을 이해하는 데 활용할 수 있는 미국 National Institute of Standards and Technology, NIST(미국 국립표준기술연구소)의 공식 통계자료이다.
- 바로가기: NIST 공식 원출처
- 「NIST/SEMATECH e-Handbook of Statistical Methods ― Confidence Limits for the Mean」
- 평균에 대한 Confidence Interval(신뢰구간), t-test(t검정), Significance Level(유의수준)과 가설검정 관계를 공식 예제와 함께 설명한다.
- 바로가기: NIST 공식 원출처
- 「NIST/SEMATECH e-Handbook of Statistical Methods ― What are Confidence Intervals?」
- Confidence Level(신뢰수준)의 반복표본 관점과 Confidence Interval(신뢰구간)의 기본개념을 이해하는 데 활용할 수 있다.
- 바로가기: NIST 공식 원출처
- 「연구윤리 확보를 위한 지침」
- 연구자의 책임, 연구자료 관리와 연구부정행위 예방 등 연구결과 작성과 보고에서 필요한 연구윤리 원칙을 확인할 수 있는 교육부 행정규칙이다.
- 바로가기: 국가법령정보센터
- 「국토교통부 실거래가 공개시스템」
- 토지·공장·창고 등 실제 거래가격과 면적·거래시점 등의 자료를 이용하여 가설검증과 실증분석을 수행할 때 활용하는 공식 자료원이다.
- 바로가기: 국토교통부 실거래가 공개시스템
- 「한국부동산원 R-ONE 부동산통계정보시스템」
- 부동산 가격·거래·지가·상업용부동산 등 시장통계를 제공하여 연구결과의 비교와 시장환경 해석에 활용할 수 있다.
- 바로가기: 한국부동산원 R-ONE
- 「국가통계포털(KOSIS)」
- 인구·산업·사업체·지역경제 등 다양한 국가승인통계를 제공하여 부동산 연구의 설명변수·통제변수 및 결과해석에 활용할 수 있다.
- 바로가기: 국가통계포털 KOSIS
- 「조상현 공인중개사 30년 실무 경험 및 현장 상담 기록」
- 토지·공장·창고·상가·아파트와 기업 사업용 부동산의 가격·거래기간·공실·입지·계약성사 및 실패사례 등 실무경험을 연구가설과 실증결과로 연결하기 위한 경험적 자료이다.
- 바로가기: 조상현 부동산 연구 콘텐츠
[실무 유의사항]
- p-value(유의확률)는 연구가설이 참일 확률이 아니다.
- p≥0.05라고 해서 효과가 존재하지 않는다고 단정하지 않는다.
- Confidence Interval(신뢰구간)과 Effect Size(효과크기)를 함께 확인한다.
- 비유의 결과와 예상과 반대되는 결과도 누락하지 않는다.
- 통계적 유의성과 실무적 중요성을 구분한다.
- 관찰자료의 통계적 관계를 곧바로 인과관계로 해석하지 않는다.
- 표본크기·측정오차·검정력·누락변수 가능성을 함께 검토한다.
- 부동산 공공데이터는 기준시점·지역단위·자료정의를 확인한다.
- 법령·연구윤리·개인정보 기준은 실제 연구 수행 시점에 최신 내용을 다시 확인한다.
- AI가 작성한 통계해석과 결과문장은 반드시 연구자가 실제 분석표와 대조하여 검증한다.
H2. 12. 관련글(Related Posts)(8대 핵심 가이드)
📞 상담 및 문의
조상현 공인중개사 / 경영학박사과정
컴퓨터공학 · 부동산학 · 경영학 · 신학 · 경영학 박사과정 · Golf Teaching Pro /
010-3344-3208
공인중개사 30년 실무 경험을 바탕으로
토지·공장·창고의 입지분석, 개발 가능성 및 기업용 부동산의 실무 타당성 검토 상담
실제 수익 중심으로 정확하게 상담해드립니다.
[개인 부동산 투자 상담]
토지 • 공장 • 창고 • 상가 • 아파트의 입지분석, 매입·매각, 개발가능성, 투자 타당성 및 실제 수익구조를 검토합니다.
[기업 전용 부동산·경영 컨설팅 트랙]
① 기업 자산 실사 및 신규 입지 타당성 분석
공장·물류창고·사업용 토지의 입지, 대형차량 접근성, 용수, 전력용량, 인허가 조건, IC 접근성, 주변 산업환경 및 확장 가능성을 종합적으로 분석합니다.
② 기업 부동산 자산 포트폴리오 재편
법인이 보유한 사업용·비사업용 부동산의 활용가치, 매각 필요성, 이전·통합 가능성, 유휴자산 활용 및 자산유동화 전략을 기업의 경영계획과 연계하여 검토합니다.
③ 기업 공장·물류센터 이전 및 확장 컨설팅
생산량 증가, 물류비 절감 및 사업확장에 따른 신규 공장·창고·연구시설·사옥의 후보지 비교, 입지선정 및 부동산 확보전략을 검토합니다.
④ 개발사업 및 투자 타당성 분석
토지개발, 공장·창고 개발 및 사업용 부동산 투자에 대해 예상사업비, 입지조건, 인허가, 임대·매각 가능성, 시장수요와 주요 위험요인을 종합적으로 분석합니다.
⑤ 부동산 개발 PF(Project Financing, 프로젝트 파이낸싱) 기초 사업성 및 경영 자문
토지가격, 개발비, 예상매출, 임대수익, 금융비용, 손익분기구조와 주요 위험변수를 분석하여 사업 초기의 투자 및 경영 의사결정 자료를 구축합니다.
⑥ 공간·입지 데이터 기반 연구용역 및 경영 자문
부동산 실거래, 공시가격, 교통, 입지, 산업·물류환경 등 활용 가능한 데이터를 바탕으로 기업의 입지전략, 자산전략, 개발전략 및 투자 의사결정을 위한 조사·분석과 연구자문을 수행합니다.
개인 투자자의 토지 • 공장 • 창고 • 상가 • 아파트 투자부터 기업의 공장·물류센터 입지선정 • 기업 자산 실사 • 사업용 부동산 취득·매각 • 자산 포트폴리오 재편 • 공장·물류센터 이전 및 확장 • 개발사업 및 투자 타당성 분석 • 부동산 개발 PF(Project Financing, 프로젝트 파이낸싱) 기초 사업성 검토 • 공간·입지 데이터 기반 연구용역 • 기업 부동산 경영전략까지, 공인중개사 30년 실무 경험과 부동산학·경영학·데이터 분석의 융합적 관점으로 개인의 실제 수익과 기업가치 향상에 필요한 의사결정을 상담합니다.


