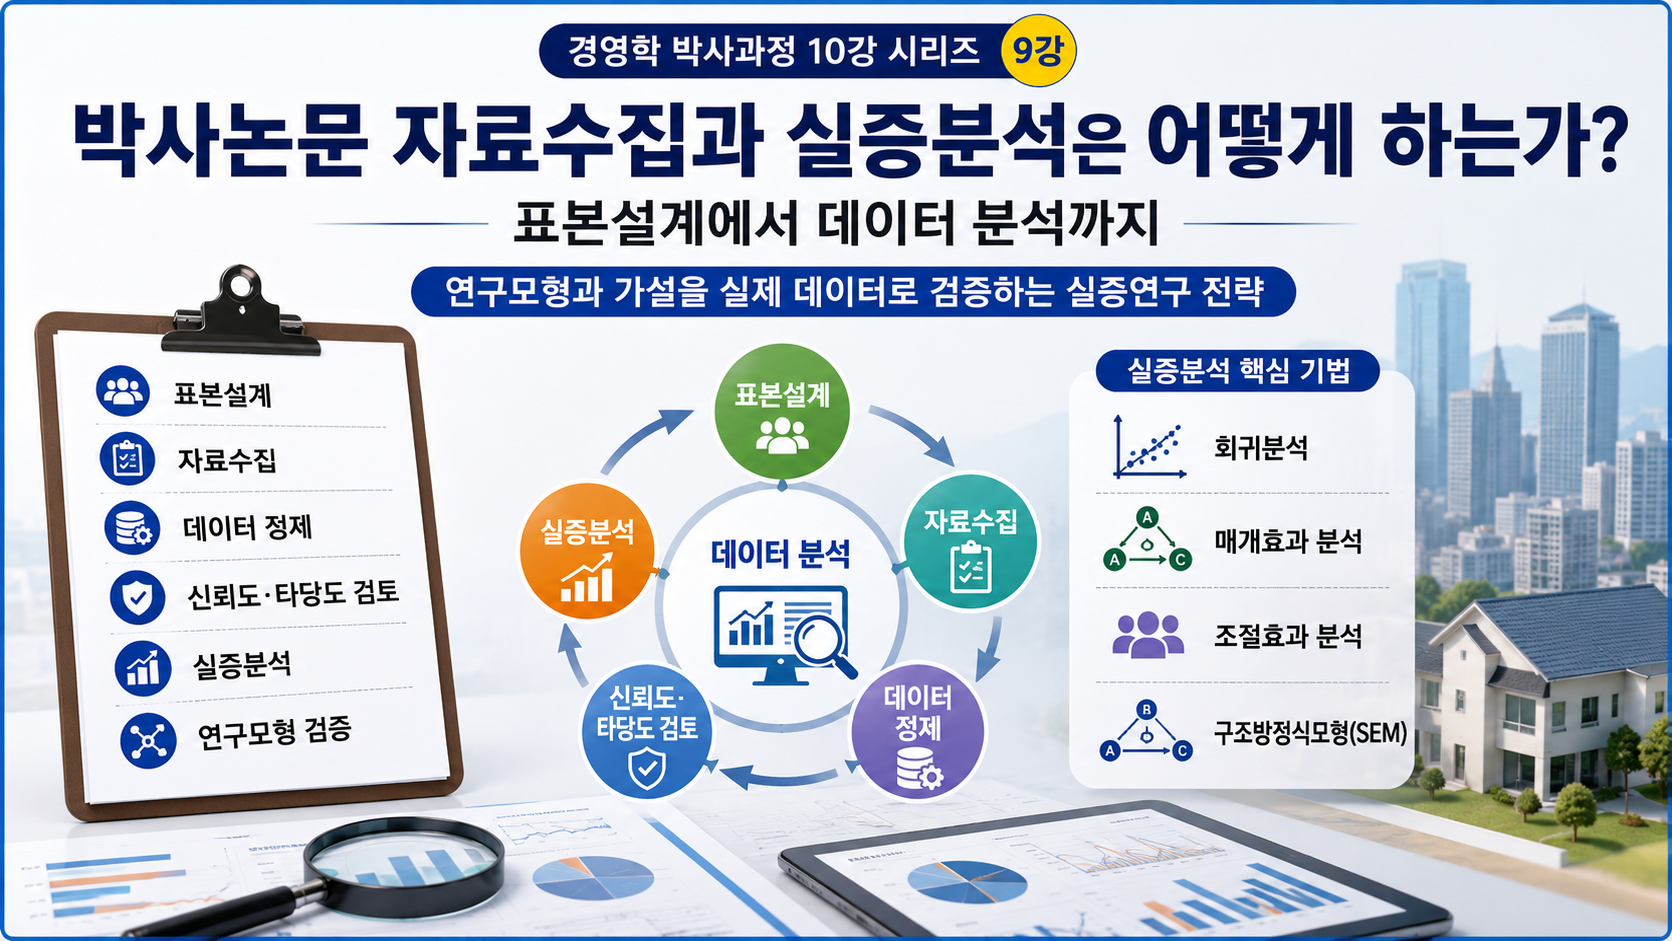
H1. 박사논문 자료수집과 실증분석은 어떻게 하는가? 표본설계에서 데이터 분석까지 (공인중개사 30년 실무 경험)
부제: Research Model과 Hypothesis를 실제 데이터로 검증하기 위해 표본설계, 자료수집, 데이터 정제, 신뢰도·타당도 검토, 회귀분석·매개·조절·SEM까지 연결하는 부동산경영 박사논문 실증연구 전략
본 글은 국내외 선행연구, 경영학 연구방법론, 통계적 실증분석 자료, 부동산학 연구자료 및 공인중개사 30년 실무 경험을 바탕으로 작성한 논문형 연구 블로그입니다. 컴퓨터공학 · 부동산학 · 경영학 · 신학 · 경영학 박사과정 · Golf Teaching Pro
H2. 0. 초록(Abstract)
제8강에서는 전문성·신뢰·서비스품질·시장수요처럼 직접 관찰하기 어려운 개념을 조작적 정의와 설문문항으로 전환하는 방법을 살펴보았다.
이제 박사논문의 연구모형과 가설을 실제 데이터로 검증해야 한다.
이 단계의 핵심은 단순히 설문지를 많이 배포하는 것이 아니다.
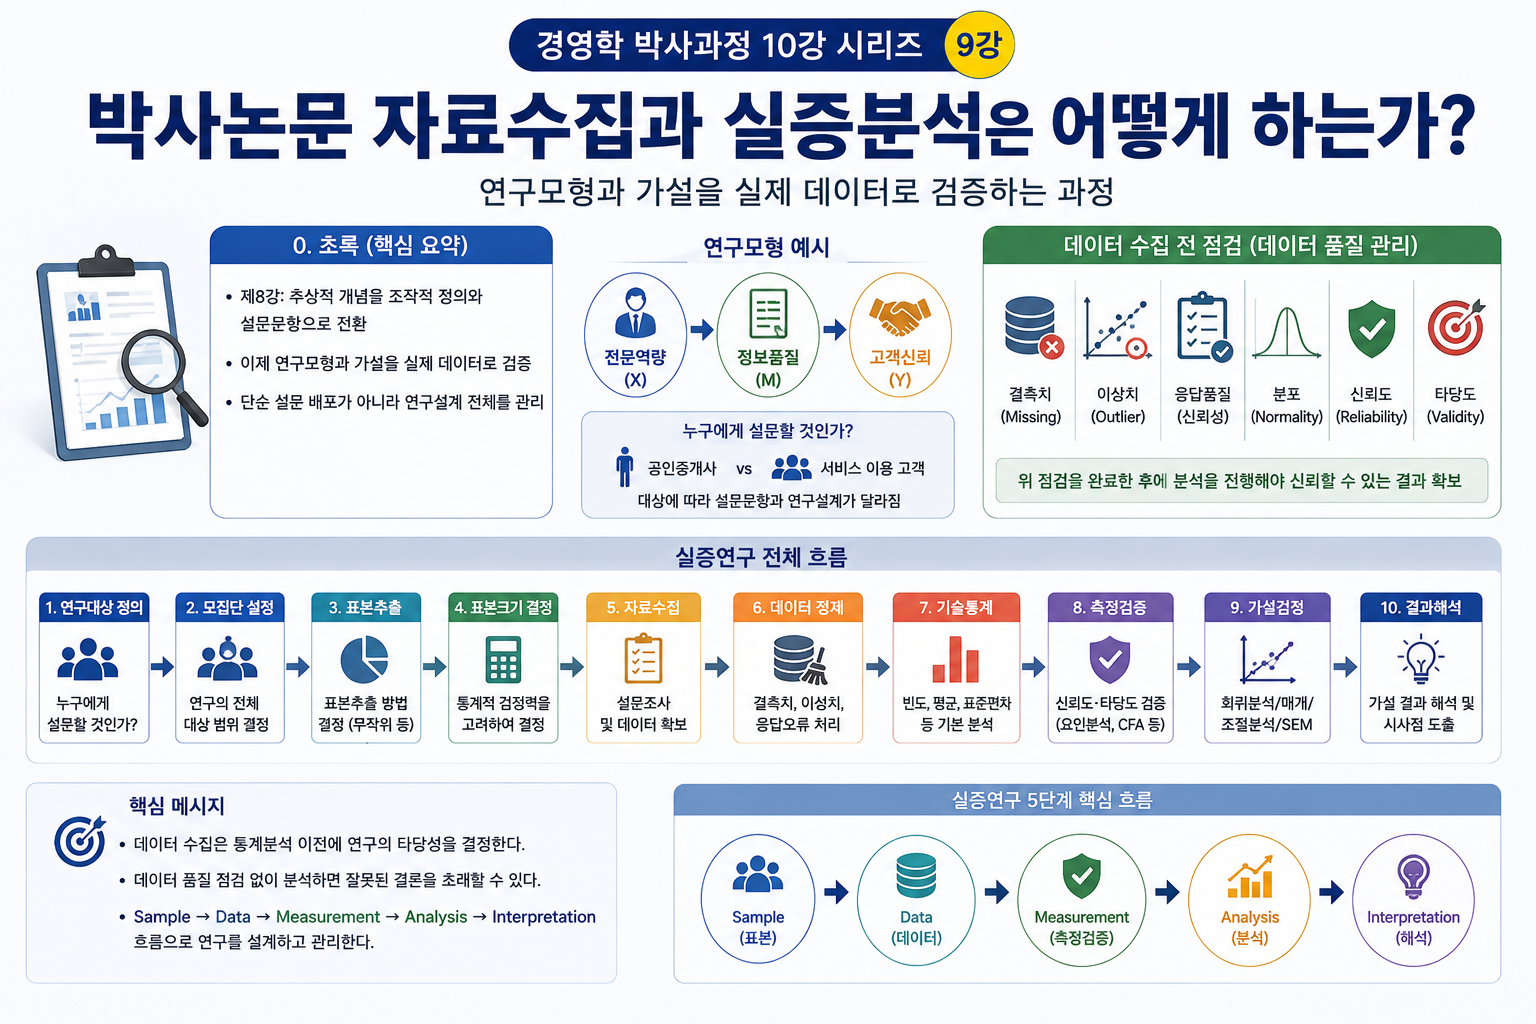
연구대상 정의 → 모집단 설정 → 표본추출 → 표본크기 결정 → 자료수집 → 데이터 정제 → 기술통계 → 측정검증 → 가설검정 → 결과해석
의 전체 과정을 하나의 연구설계로 관리하는 것이다.
예를 들어 다음 연구모형이 있다고 하자.
공인중개사의 전문역량(X) → 정보품질(M) → 고객신뢰(Y)
이 연구를 검증하려면 먼저 누구의 응답을 받아야 하는지 정해야 한다.
실제 공인중개사에게 물을 것인지, 중개서비스를 이용한 고객에게 물을 것인지에 따라 연구대상과 설문문항이 완전히 달라진다.
이처럼 데이터 수집은 통계분석 이전에 이미 연구의 타당성을 결정한다.
또한 수집된 데이터가 있다고 해서 곧바로 회귀분석이나 SEM을 실행해서는 안 된다.
먼저
결측치 → 이상치 → 응답품질 → 분포 → 신뢰도 → 타당도
를 점검해야 한다.
따라서 제9강은 박사논문의 실증연구를
Sample → Data → Measurement → Analysis → Interpretation
의 흐름으로 이해하는 과정이다.
H2. 1. 서론(Introduction)
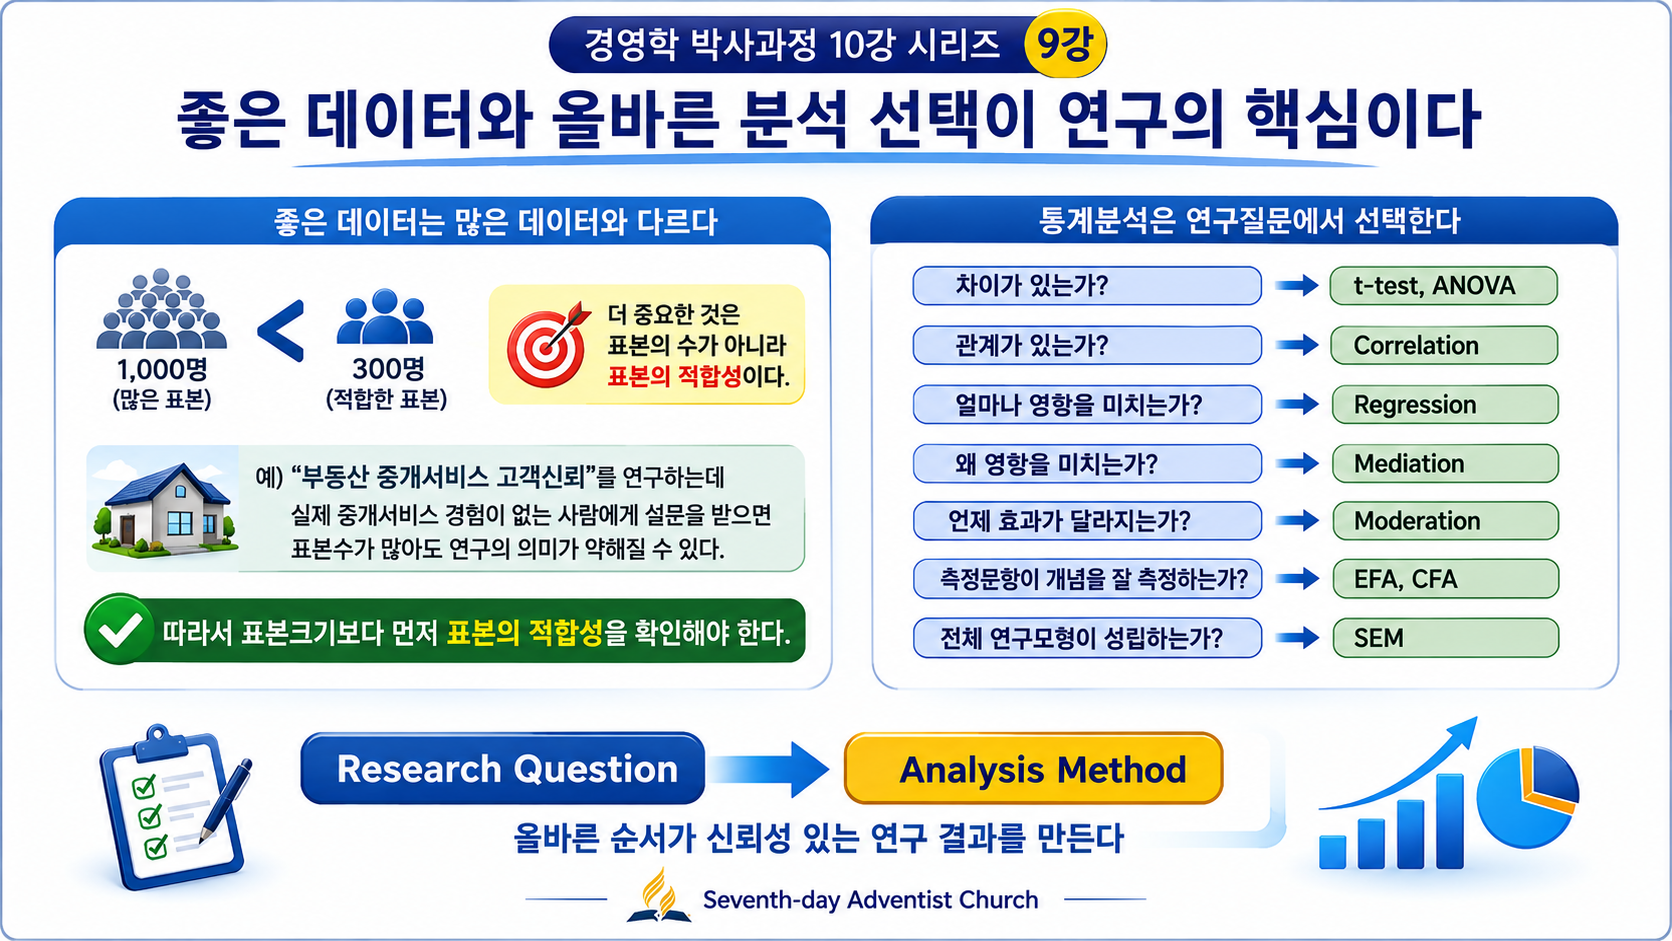
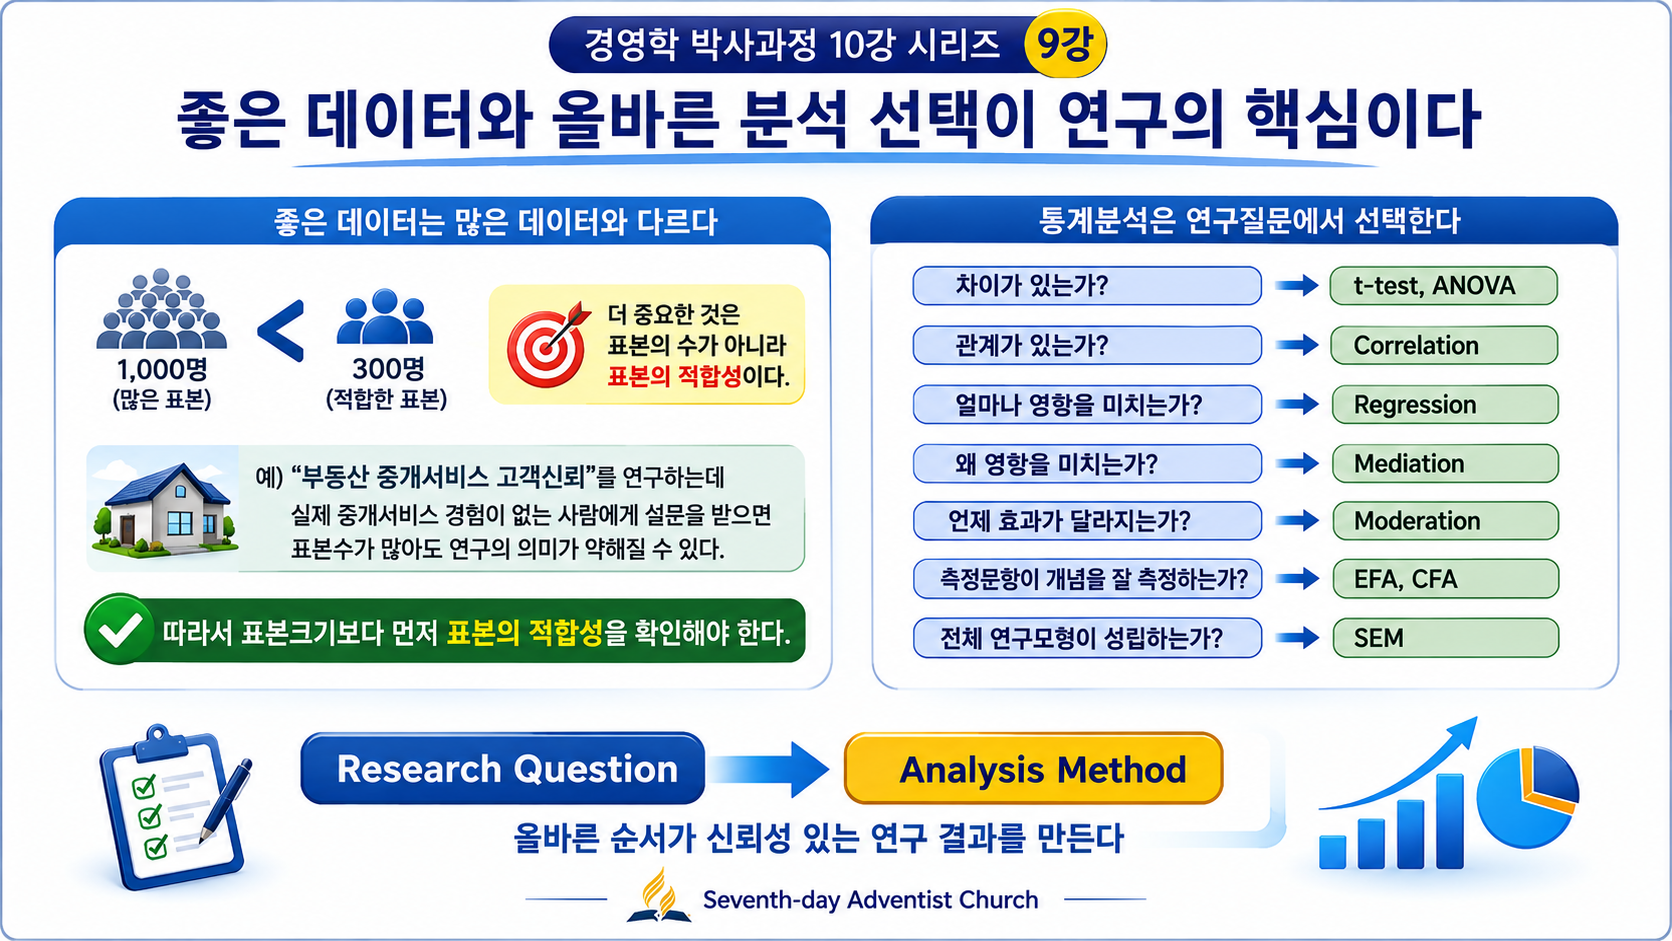
H3. 1.1 좋은 데이터는 많은 데이터와 다르다
표본수가 많으면 연구가 좋아질 것이라고 생각하기 쉽다.
그러나 잘못 선정된 응답자 1,000명의 데이터보다 연구대상에 정확히 맞는 300명의 데이터가 더 의미 있을 수 있다.
예를 들어 “부동산 중개서비스 고객신뢰”를 연구하면서 실제 중개서비스 경험이 없는 사람에게 설문을 받는다면 표본수가 많더라도 연구의 의미가 약해질 수 있다.
따라서
표본크기보다 먼저 표본의 적합성
을 확인해야 한다.
H3. 1.2 통계분석은 연구질문에서 선택해야 한다
통계프로그램에서 메뉴를 먼저 선택하면 안 된다.
연구질문에 따라 분석방법을 결정해야 한다.
차이가 있는가? → t-test, ANOVA
관계가 있는가? → Correlation
얼마나 영향을 미치는가? → Regression
왜 영향을 미치는가? → Mediation
언제 효과가 달라지는가? → Moderation
측정문항이 개념을 잘 측정하는가? → EFA, CFA
전체 연구모형이 성립하는가? → SEM
즉,
Research Question → Analysis Method
의 순서가 중요하다.
H2. 2. 이론적 배경(Literature Review)
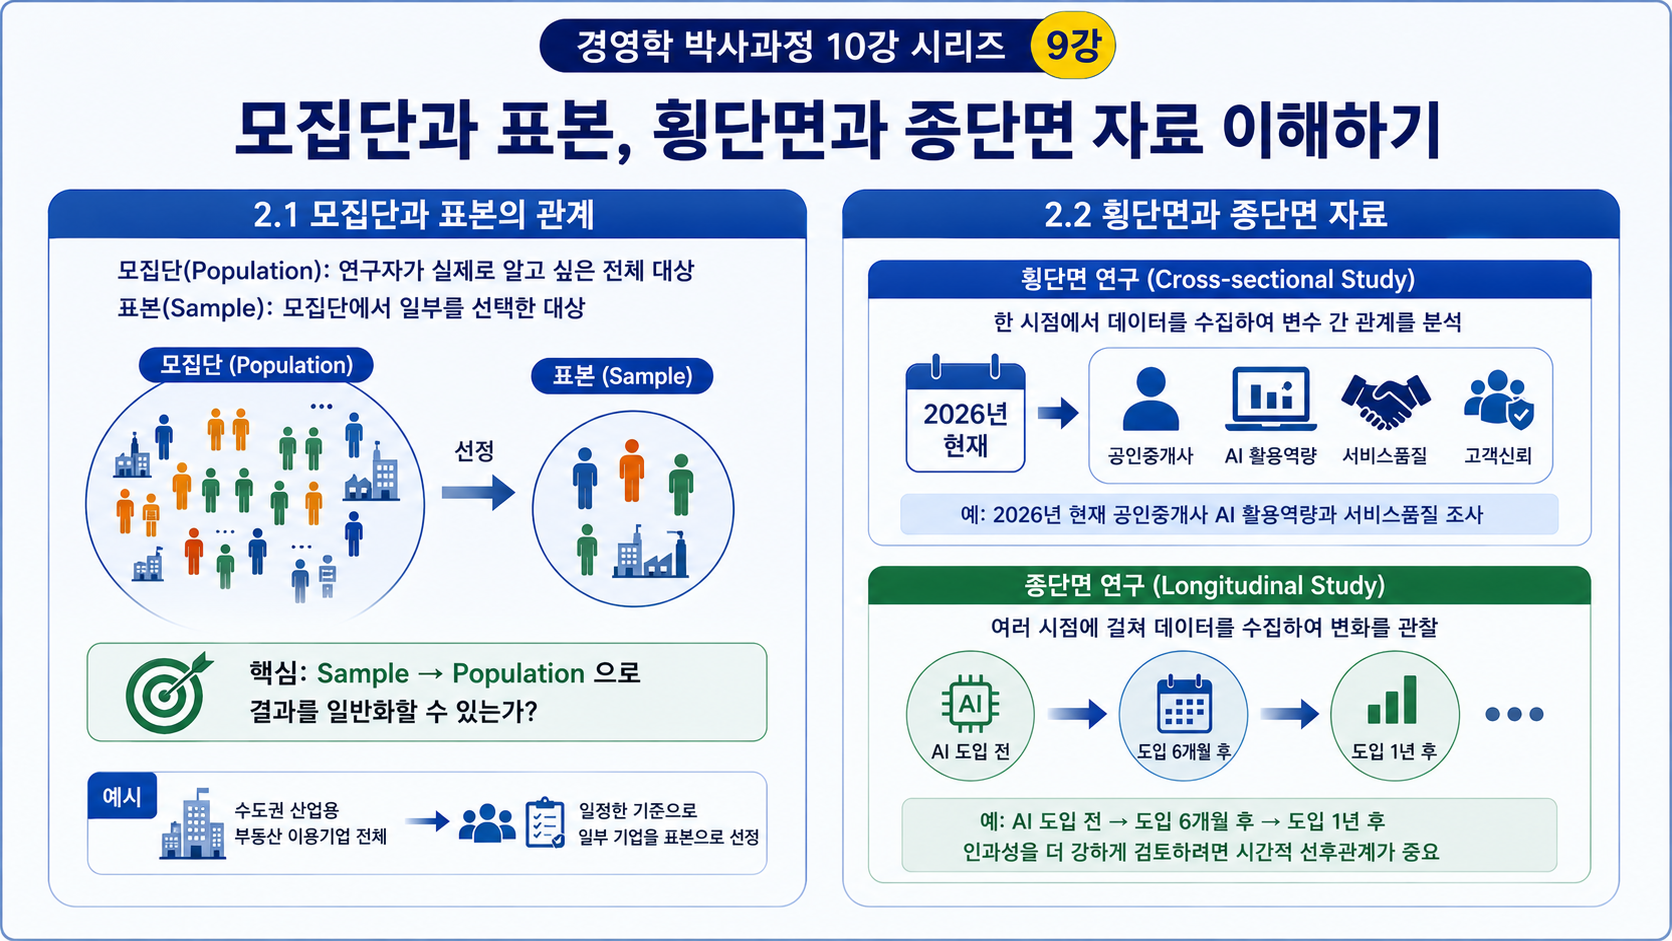
H3. 2.1 모집단과 표본의 관계
연구자가 실제로 알고 싶은 전체 대상을 모집단(Population)이라고 한다.
그러나 모든 대상을 조사하기 어려우므로 일부를 선택한다.
이것이 표본(Sample)이다.
예를 들어 수도권 산업용 부동산 이용기업 전체를 연구하고 싶지만 모두 조사할 수 없다면 일정한 기준으로 일부 기업을 표본으로 선정한다.
핵심은
Sample → Population
으로 결과를 일반화할 수 있는가이다.
H3. 2.2 횡단면과 종단면 자료
횡단면 연구(Cross-sectional Study)는 한 시점에서 데이터를 수집한다.
예:
2026년 현재 공인중개사 AI 활용역량과 서비스품질 조사
종단면 연구(Longitudinal Study)는 여러 시점에 걸쳐 변화를 관찰한다.
예:
AI 도입 전 → 도입 6개월 후 → 도입 1년 후
인과성을 더 강하게 검토하려면 시간적 선후관계가 중요하므로 연구목적에 따라 자료구조를 신중히 선택해야 한다.
H2. 3. 핵심 용어 정리
| 한글(한자) | 영어 원어·약어·IPA | 뜻 + 부동산 실무 의미 |
|---|---|---|
| 모집단 (母集團) |
Population /ˌpɑːpjəˈleɪʃən/ |
연구하려는 전체 대상 |
| 표본 (標本) |
Sample /ˈsæmpəl/ |
실제 조사하는 일부 대상 |
| 표본추출 (標本抽出) |
Sampling /ˈsæmplɪŋ/ |
조사대상을 선택하는 과정 |
| 결측치 (缺測値) |
Missing Value /ˈmɪsɪŋ ˈvæljuː/ |
누락된 응답·거래자료 |
| 이상치 (異常値) |
Outlier /ˈaʊtˌlaɪər/ |
지나치게 크거나 작은 값 |
| 기술통계 (記述統計) |
Descriptive Statistics /dɪˈskrɪptɪv stəˈtɪstɪks/ |
평균·분포 등 자료 요약 |
| 실증분석 (實證分析) |
Empirical Analysis /ɪmˈpɪrɪkəl əˈnæləsɪs/ |
실제 자료로 가설 검증 |
| 구조방정식모형 (構造方程式模型) |
Structural Equation Modeling · SEM /ˈstrʌktʃərəl ɪˈkweɪʒən ˈmɑːdəlɪŋ/ |
복합 변수관계를 분석 |
| 탐색적 요인분석 (探索的要因分析) |
Exploratory Factor Analysis · EFA /ɪkˈsplɔːrətɔːri ˈfæktər əˈnæləsɪs/ |
문항의 요인구조 탐색 |
| 확인적 요인분석 (確認的要因分析) |
Confirmatory Factor Analysis · CFA /kənˈfɜːrmətɔːri ˈfæktər əˈnæləsɪs/ |
측정모형의 구조 확인 |
| 회귀분석 (回歸分析) |
Regression Analysis /rɪˈɡreʃən əˈnæləsɪs/ |
변수 간 영향관계 분석 |
| 상관분석 (相關分析) |
Correlation Analysis /ˌkɔːrəˈleɪʃən əˈnæləsɪs/ |
변수 간 관련성 분석 |
| 표준편차 (標準偏差) |
Standard Deviation · SD /ˈstændərd ˌdiːviˈeɪʃən/ |
자료의 흩어진 정도 |
| 정규성 (正規性) |
Normality /nɔːrˈmæləti/ |
자료의 정규분포 여부 |
| 다중공선성 (多重共線性) |
Multicollinearity /ˌmʌltikəˌlɪniˈærəti/ |
독립변수 간 높은 상관 |
H2. 4. 핵심 이론 분석 ― 자료수집과 실증분석 10단계
H3. 4.1 제1단계 ― 분석단위를 결정한다
가장 먼저 “누구 또는 무엇이 한 개의 데이터인가?”를 정해야 한다.
예를 들어
개별 고객
개별 공인중개사
개별 부동산
개별 기업
개별 거래
중 무엇이 분석단위인지 명확해야 한다.
분석단위가 불명확하면 설문과 통계모형도 흔들린다.
H3. 4.2 제2단계 ― 모집단을 정의한다
예를 들어
“최근 3년 이내 수도권에서 공인중개사를 통해 부동산 거래 또는 상담 경험이 있는 성인 고객”
처럼 대상 조건을 구체적으로 정의할 수 있다.
단순히
“부동산 고객”
이라고 하면 모집단이 너무 모호하다.
H3. 4.3 제3단계 ― 표본추출 방법을 선택한다
대표적인 방법은 크게 확률표본추출과 비확률표본추출로 나눌 수 있다.
확률표본:
단순무작위 → 층화 → 군집
비확률표본:
편의 → 판단 → 할당 → 눈덩이
박사논문에서는 현실적인 접근 가능성과 대표성을 함께 고려해야 한다.
H3. 4.4 제4단계 ― 표본크기를 결정한다
표본크기는 “무조건 200명 이상”처럼 하나의 숫자로 정해지는 것이 아니다.
다음 요소를 고려해야 한다.
연구모형 복잡성
변수 수
분석방법
예상 효과크기
통계적 검정력
응답률
특히 회귀·SEM·CFA 등 분석방법에 따라 필요한 표본수 판단 기준이 달라질 수 있으므로 사전 검정력 분석(Power Analysis)도 고려할 수 있다.
H3. 4.5 제5단계 ― 본조사를 실시한다
설문조사에서는 단순히 많은 응답을 받는 것보다 응답품질 관리가 중요하다.
확인할 항목은
조사대상 적격성
중복응답
비정상적으로 빠른 응답
모든 문항 동일번호 선택
논리적으로 모순되는 응답
등이다.
H3. 4.6 제6단계 ― 데이터를 정제한다
수집된 원자료를 그대로 분석해서는 안 된다.
먼저
결측치 확인 → 이상치 확인 → 중복확인 → 코딩오류 확인 → 역문항 처리 → 비정상응답 제거
과정을 거친다.
데이터 정제과정도 논문에서 투명하게 설명하는 것이 좋다.
H3. 4.7 제7단계 ― 기술통계와 분포를 확인한다
본격적인 가설검정 이전에 데이터의 전체 모습을 먼저 본다.
빈도
평균
표준편차
최솟값·최댓값
왜도
첨도
등을 검토한다.
이 과정은 데이터의 건강검진과 같다.
H3. 4.8 제8단계 ― 측정모형을 검증한다
잠재변수를 설문으로 측정했다면 측정품질을 확인한다.
일반적으로
신뢰도 → EFA → CFA → 수렴타당도 → 판별타당도
등을 검토한다.
예를 들어 고객신뢰 문항 5개가 정말 하나의 동일한 Construct를 측정하고 있는지 확인해야 한다.
측정이 불안정한 상태에서 구조모형을 분석하면 결과 해석도 불안정해질 수 있다.
H3. 4.9 제9단계 ― 연구가설을 검증한다
연구질문에 따라 분석방법을 선택한다.
기본적인 흐름은
상관관계 → 회귀분석 → 매개효과 → 조절효과 → 필요 시 조건부 과정분석
으로 발전할 수 있다.
잠재변수 중심의 복합모형이라면 SEM을 활용할 수 있다.
H3. 4.10 제10단계 ― 통계적 유의성과 실질적 의미를 함께 해석한다
p값만 보고 결론을 내려서는 안 된다.
예를 들어 통계적으로 유의하지만 효과크기가 매우 작을 수 있다.
따라서
유의성 + 효과크기 + 설명력 + 신뢰구간 + 이론적 의미 + 실무적 의미
를 함께 검토해야 한다.
H2. 5. 실무 사례 연구(Case Study)
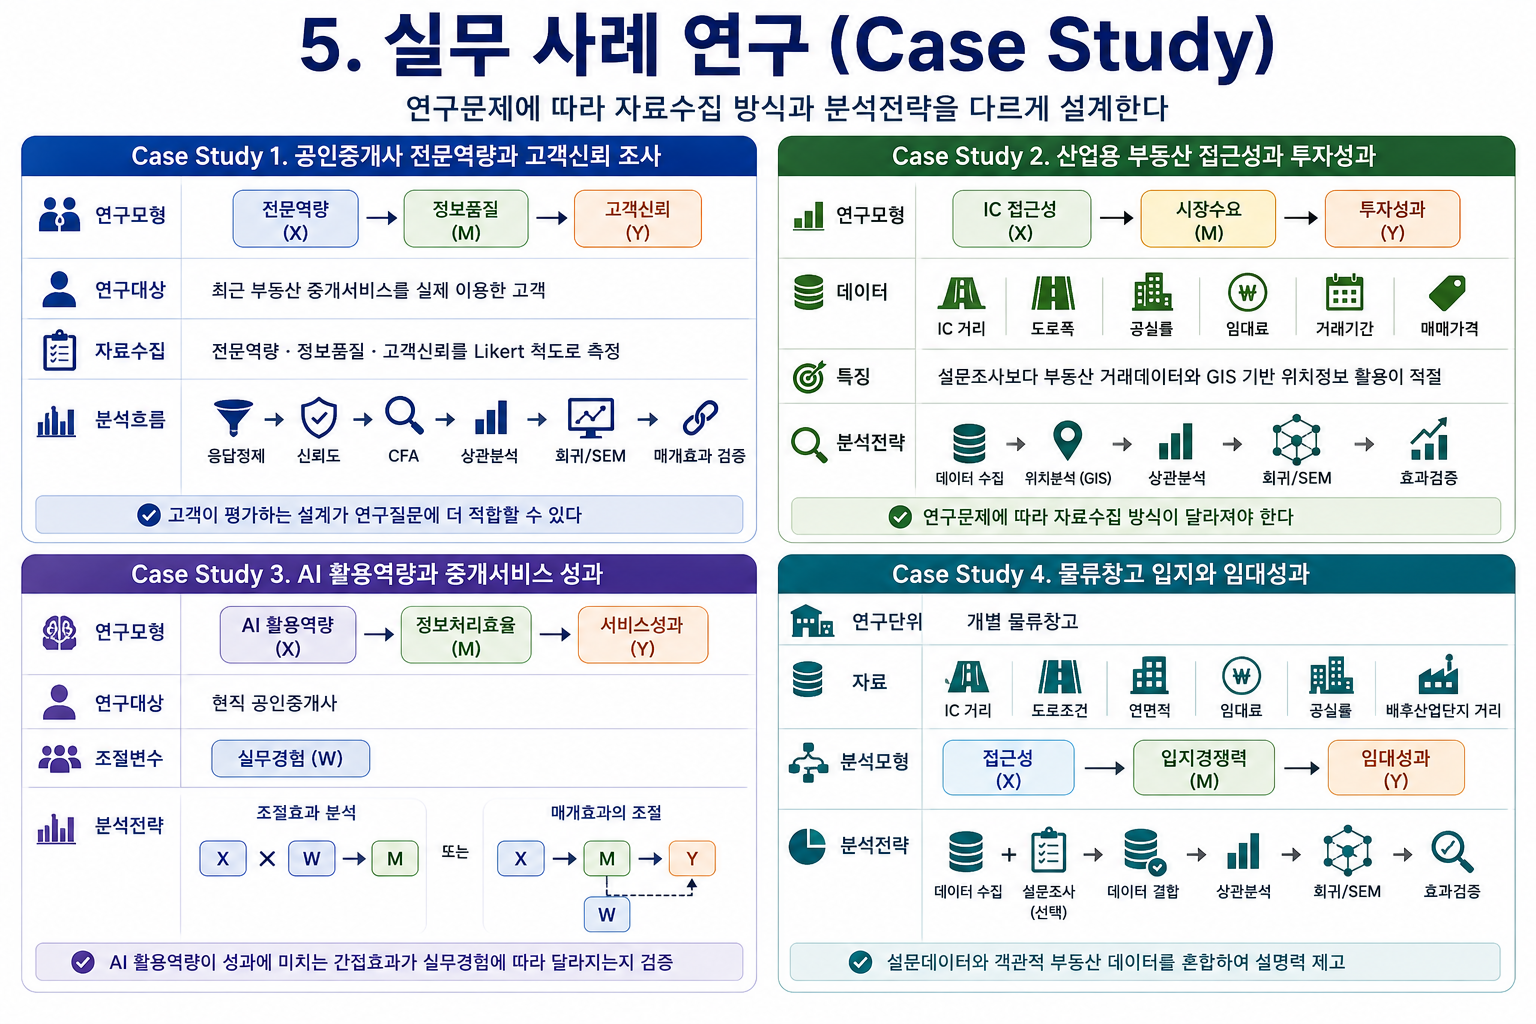
실무 사례 연구(Case Study) : ‘연구모형과 가설’의 특성에 따라 표본 대상과 자료수집 방법을 맞춤형으로 설계하는 4가지 실전 전략
일반대학원 경영학 박사과정의 연구자가 이론적 배경을 세우고 정교한 가설까지 도출했다면, 이제 마주하는 가장 실제적이고 거대한 관문은 바로 “도대체 누구를 대상으로, 어떤 데이터를 어떻게 수집하여 검증할 것인가?” 하는 자료수집(Data Collection)과 표본설계(Sample Design)의 단계입니다. 아무리 가설이 훌륭해도 조사의 대상이 잘못되거나 데이터의 성격이 연구모형과 맞지 않으면 통계분석 결과는 모래성처럼 무너지고 맙니다. 정통 경영학 및 부동산경영 실증연구가 되기 위해서는 연구질문의 본질에 따라 현직 공인중개사를 조사해야 할지, 실제 부동산을 이용한 고객을 타깃으로 삼아야 할지, 혹은 주관적 설문이 아니라 차가운 GIS 공간 데이터와 실거래가를 결합해야 할지 치밀하게 결정해야 합니다. 공인중개사로서 30년간 현장의 최전선을 지키며 체득한 날것 그대로의 경험을 바탕으로, 연구모형에 최적화된 표본과 데이터 수집 전략을 세우는 4가지 실무 사례를 스토리텔링 형식으로 구체적으로 살펴보고자 합니다.
Case Study 1. 공인중개사 전문역량과 고객신뢰 조사
수십 년간 중개 현장을 지켜온 조박사님은 “전문성이 높은 중개사가 고객의 신뢰를 얻는다”는 가설을 검증하기 위해 설문지를 설계할 때 중요한 방법론적 갈림길에 섰습니다. “과연 이 설문 문항에 답할 응답자는 공인중개사 본인이어야 하는가, 아니면 서비스를 직접 이용한 고객이어야 하는가?”
초보 연구자들이 흔히 저지르는 실수는 조사의 편의성 때문에 중개사들에게 직접 설문을 돌려 “당신은 전문성이 높습니까? 고객이 당신을 신뢰합니까?”라고 묻는 것입니다. 하지만 이는 자기보고식 편의(Self-report bias)로 인해 연구의 객관성을 심각하게 해칩니다. 따라서 본 연구에서는 최근 실제 부동산 중개서비스를 이용한 ‘고객’을 최종 조사대상으로 선정합니다. 고객이 직접 공인중개사의 전문역량, 정보품질, 그리고 최종 고객신뢰를 평가하도록 설문지를 설계하고, 데이터 정제, 신뢰도 분석, 확인적 요인분석(CFA), 상관분석을 거쳐 최종 구조방정식 모형(SEM)을 통해 매개효과를 검증하는 정통 소비자행동·서비스경영 연구의 궤도에 오르게 됩니다.
-
실무적 검증 흐름: 연구모형 설정(전문역량 → 정보품질 → 고객신뢰) -> 응답자 타깃팅 오류 극복(중개사가 아닌 실제 이용 고객 대상 선정) -> 실증 분석 체계화(응답정제 → CFA → SEM 매개검증)
-
교훈: 누구를 대상으로 데이터를 수집하느냐는 연구의 타당성을 결정하는 생명줄이므로, 연구질문의 성격에 정확히 부합하는 타깃 응답자를 설정해야 합니다.
Case Study 2. 산업용 부동산 접근성과 투자성과
공장과 물류창고 같은 산업용 부동산을 연구할 때, 조박사님은 또 한 번 근본적인 질문을 던졌습니다. “고속도로 IC 접근성이 투자성과에 미치는 영향을 검증하기 위해 과연 중개사들이나 기업 대표들에게 설문지를 돌리는 것이 올바른 방법인가?”
산업용 부동산의 가치와 거래 속도는 주관적인 ‘만족도’나 ‘느낌’으로 측정할 수 있는 성격이 아닙니다. 이 모형을 검증하기 위해서는 설문조사라는 방식을 과감히 내려놓고, 객관적인 공간 데이터와 실거래 데이터의 바다로 뛰어들어야 합니다. GIS(지리정보시스템)를 활용하여 IC까지의 실제 도로 거리, 도로폭, 공실률, 임대료, 평균 거래기간, 그리고 매매가격 등 차갑고 객관적인 물류·금융 데이터를 수집합니다. 즉, 연구문제와 데이터의 성격이 일치하지 않을 때는 설문이라는 틀에 얽매이지 않고 객관적 공간·시장 데이터를 결합하는 과감한 데이터 원천 전환이 필요함을 보여줍니다.
-
실무적 검증 흐름: 연구모형 설정(IC 접근성 → 시장수요 → 투자성과) -> 주관적 설문의 한계 직시(객관적 데이터의 필요성 공감) -> 최종 데이터 설계(GIS 위치정보, 실거래가, 공실률 등 객관적 물리 데이터 결합)
-
교훈: 모든 연구를 설문조사로 해결하려 하지 말고, 연구문제의 특성에 따라 GIS 공간 데이터와 객관적 시장 지표를 적극적으로 채택해야 합니다.
Case Study 3. AI 활용역량과 중개서비스 성과
최근 프롭테크와 생성형 AI가 쏟아지면서 “AI를 잘 다루는 공인중개사가 과연 더 뛰어난 성과를 거두는가?”를 실증하기 위해, 조박사님은 이번에는 조사의 타깃을 일반 고객이 아닌 ‘현직 공인중개사’로 정확히 조준했습니다.
현직 중개사들을 대상으로 AI 활용역량(X)이 정보처리 효율(M)을 거쳐 최종 서비스 성과(Y)에 미치는 경로를 추적합니다. 특히 여기서 멈추지 않고, 30년 실무경험(W)이라는 강력한 조절변수를 투입하여 “AI의 활용 효과가 과연 모든 중개사에게 동일하게 나타나는가, 아니면 오랜 실무경험을 가진 베테랑이 쓸 때 그 정보처리 효율이 극대화되는가?”를 검증하는 상호작용 모형(X × W → M)을 설계합니다. 현직 전문가들의 실무 행태와 기술 수용 과정을 입체적으로 파고드는 고난도 실증 연구의 모범 답안이 완성됩니다.
-
실무적 검증 흐름: 연구모형 설정(AI 활용역량 → 정보처리 효율 → 서비스성과 / 실무경험의 조절효과) -> 타깃 응답자 전환(현직 공인중개사 대상 표본 추출) -> 분석 설계(조절매개 효과 및 상호작용 검증)
-
교훈: 기술 수용과 실무 성과의 관계를 밝힐 때는 현직 실무자들을 대상으로 표본을 설계하고, 경륜이라는 조절효과를 투입하여 연구의 깊이를 더해야 합니다.
Case Study 4. 물류창고 입지와 임대성과
대형 물류창고의 임대 성패를 분석하는 연구를 수행할 때, 조박사님은 주관적 설문 데이터와 객관적 물류 스펙 데이터 중 하나만 선택해야 하는 딜레마에 빠졌습니다. 창고의 물리적 조건(IC 거리, 도로조건, 연면적, 배후산업단지 거리)은 객관적이지만, 임차 기업들이 체감하는 ‘입지경쟁력’이나 ‘선호도’는 주관적 인식에 가깝기 때문입니다.
이 문제를 해결하기 위해 가장 세련된 연구전략인 ‘멀티 소스 데이터(Multi-Source Data) 혼합 전략’을 채택합니다. 개별 물류창고의 물리적 공간 데이터와 공인중개사·물류 전문가들을 대상으로 한 설문 데이터를 유기적으로 결합하여, 접근성 및 물리 스펙 → 입지경쟁력(인식) → 임대성과(공실률·임대료)라는 다층적 구조방정식 모형을 구축합니다. 객관과 주관의 경계를 허물고 두 데이터의 장점을 결합함으로써, 연구의 설명력과 학술적 타당성을 극대화하는 최고의 실증 분석 모델을 완성할 수 있습니다.
-
실무적 검증 흐름: 연구모형 설정(물리적 접근성 → 입지경쟁력 → 임대성과) -> 데이터 한계 극복(설문 데이터와 객관적 공간·물류 데이터의 융합) -> 최종 분석 설계(멀티 소스 데이터를 활용한 다층적 구조방정식 분석)
-
교훈: 복잡한 부동산 경영 현상을 다룰 때는 객관적 물리 데이터와 주관적 인식 데이터를 혼합(Multi-Source)하는 전략이 연구의 설득력을 폭발적으로 높여줍니다.
H2. 6. 실무 체크리스트 ― 데이터를 분석하기 전에 확인할 사항
| 검토항목 | 확인 질문 |
|---|---|
| 분석단위 | 한 행의 데이터가 무엇을 의미하는가? |
| 모집단 | 실제로 누구에게 일반화하려는가? |
| 표본 | 연구대상과 실제 응답자가 일치하는가? |
| 표본크기 | 분석방법에 적합한 수준인가? |
| 응답품질 | 비정상·중복·불성실 응답을 점검했는가? |
| 결측치 | 누락값 처리기준이 있는가? |
| 이상치 | 극단값의 원인을 확인했는가? |
| 분포 | 기술통계와 분포를 확인했는가? |
| 측정검증 | Reliability와 Validity를 확인했는가? |
| 분석방법 | Research Question과 분석기법이 일치하는가? |
| 효과크기 | p값 외 실제 효과의 크기도 보았는가? |
| 재현성 | 분석절차와 제외기준을 기록했는가? |
H2. 7. 결론 ― 실증분석은 통계프로그램이 아니라 연구설계다
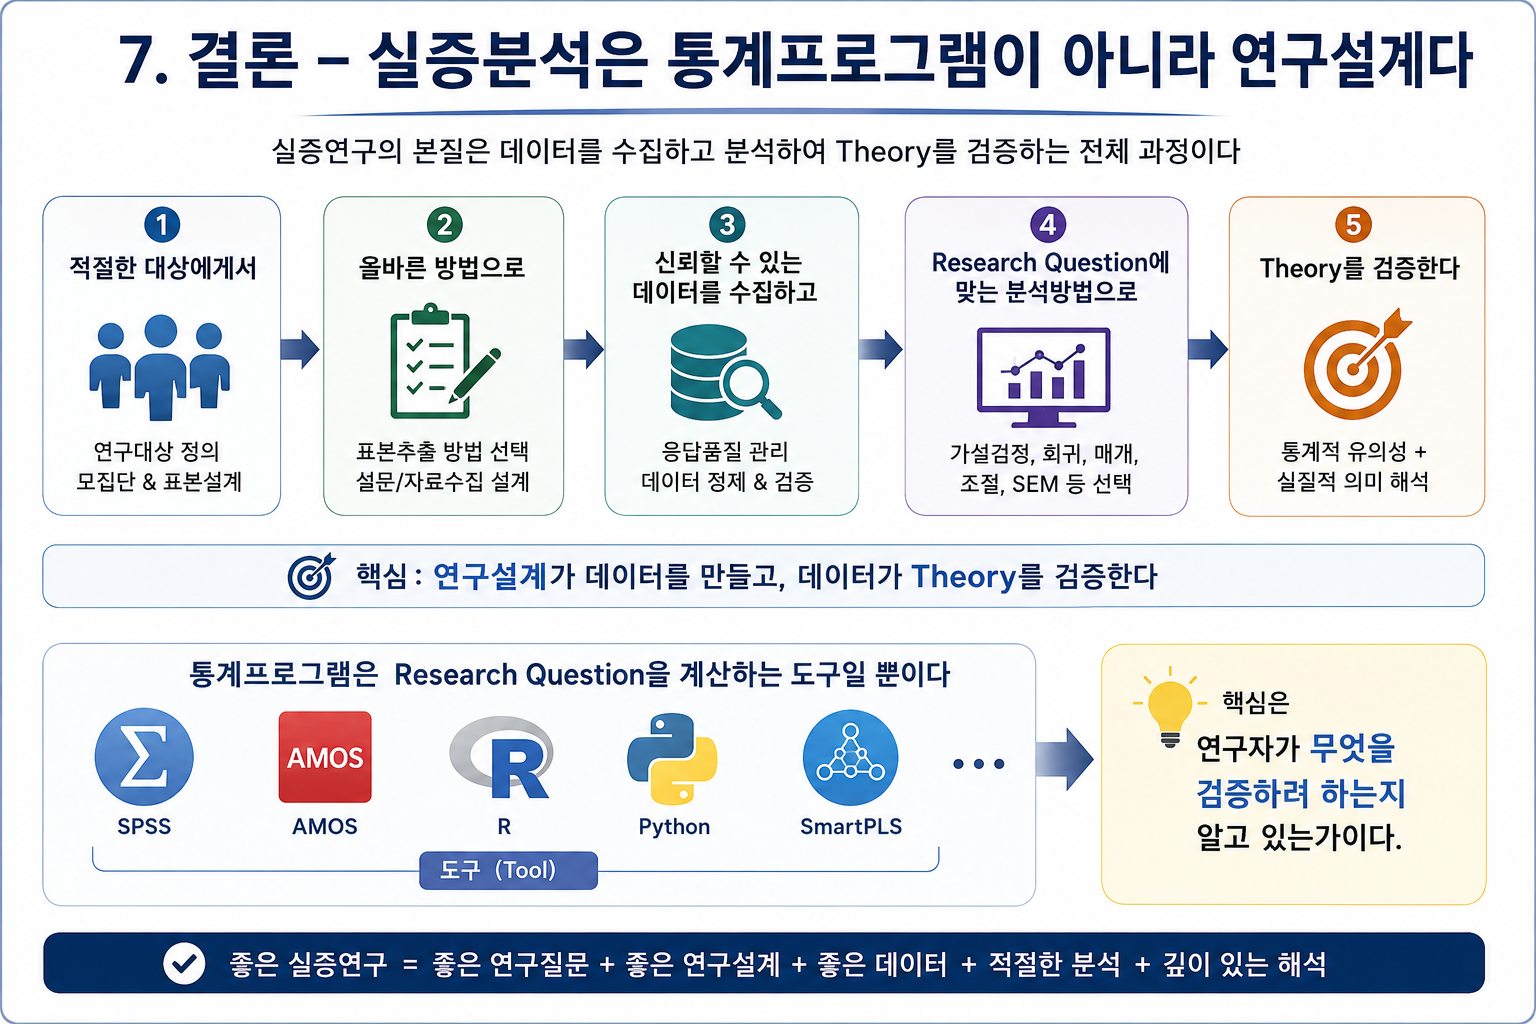
통계프로그램을 잘 사용하는 것과 좋은 실증연구를 하는 것은 동일하지 않다.
박사논문 실증연구의 본질은
적절한 대상에게서 → 올바른 방법으로 → 신뢰할 수 있는 데이터를 수집하고 → Research Question에 맞는 분석방법으로 → Theory를 검증하는 것
이다.
따라서 SPSS, AMOS, R, Python, SmartPLS 등의 프로그램은 연구자의 질문을 계산하는 도구일 뿐이다.
핵심은 연구자가 무엇을 검증하려 하는지를 알고 있는가이다.
H2. 8. 자주 묻는 질문(FAQ)
H3. Q1. 박사논문 설문은 몇 명 정도 받아야 하는가?
하나의 절대적인 기준은 없다. 분석방법, 연구모형의 복잡성, 효과크기와 검정력 등을 고려해야 한다.
H3. Q2. 표본수가 많으면 무조건 좋은가?
아니다. 연구대상에 맞는 표본인지가 먼저 중요하다.
H3. Q3. 편의표본을 사용하면 논문을 쓸 수 없는가?
그렇지는 않다. 다만 대표성과 일반화의 한계를 명확히 설명해야 한다.
H3. Q4. 설문조사만 해야 경영학 박사논문인가?
아니다. 2차자료, 패널데이터, 거래자료, 기업자료, 실험, 사례연구 등 다양한 방법이 가능하다.
H3. Q5. 객관적 부동산 데이터와 설문을 같이 사용할 수 있는가?
가능하다. 연구질문에 따라 혼합하면 오히려 설명력을 높일 수 있다.
H3. Q6. p<.05가 나오면 가설이 완전히 증명된 것인가?
아니다. 해당 연구설계와 데이터에서 통계적 근거가 나타난 것이다. 효과크기, 신뢰구간, 연구설계의 한계도 함께 고려해야 한다.
H3. Q7. 이상치는 무조건 삭제해야 하는가?
아니다. 입력오류인지 실제로 중요한 극단사례인지 먼저 확인해야 한다.
H3. Q8. 결측치는 모두 삭제하면 되는가?
결측의 규모와 발생패턴에 따라 처리방법을 결정해야 한다. 단순삭제가 항상 최선은 아니다.
H3. Q9. 회귀분석과 SEM 중 무엇이 더 좋은가?
우열의 문제가 아니다. 연구질문과 변수의 성격에 맞는 방법을 선택해야 한다.
H3. Q10. 실증분석 다음 단계는 무엇인가?
분석결과를 Theory와 기존 연구에 비추어 해석하고 연구기여와 한계를 정리하여 학위논문으로 완성하는 것이다. 이것이 제10강의 주제다.
H2. 9. 연구자의 실무 의견(Author’s Insight)
부동산 실무에서는 데이터가 항상 완벽하지 않다.
거래가격만 보더라도
급매
특수관계인 거래
개별 건축물 상태
도로조건
임차관계
세금문제
개발가능성
등 수많은 변수가 함께 작용한다.
따라서 부동산 연구자는 숫자가 존재한다는 사실만으로 그 데이터를 그대로 믿어서는 안 된다.
예를 들어 같은 30억 원 거래라도
정상시장 거래인지 → 급매인지 → 임대차가 승계되는지 → 개발권이 포함되어 있는지
에 따라 경제적 의미가 달라질 수 있다.
30년 실무경험의 강점은 바로 이러한 데이터의 Context를 읽을 수 있다는 점이다.
그러나 실증연구에서는 이 경험을 객관화해야 한다.
현장지식 → 변수정의 → 데이터 정제기준 → 통제변수 → 분석 → 해석
으로 전환해야 한다.
즉 실무경험은 통계를 대신하는 것이 아니라 데이터가 무엇을 의미하는지를 더 정확하게 해석하게 해주는 연구자산이다.
H2. 10. 정책 제언 및 연구전략
부동산경영 연구에서는 앞으로 객관적 행정·시장데이터와 설문·인지데이터를 결합하는 연구가 중요할 수 있다.
예를 들어
실거래가격 + GIS 접근성 + 공실률 + 기업수요 설문
을 결합하면 단순한 가격연구보다 시장의 작동 메커니즘을 더 풍부하게 설명할 수 있다.
AI와 빅데이터 역시 마찬가지다.
데이터가 많다고 연구품질이 자동으로 높아지는 것은 아니다.
데이터량 → 변수정의 → 표본편향 → 누락변수 → 측정오차 → 해석
을 함께 검토해야 한다.
결국 AI와 통계프로그램은 연구자를 대체하는 것이 아니라 계산과 패턴탐색을 돕는 도구다.
H2. 11. 결론(Conclusion)
제9강의 핵심은 자료를 많이 모으는 것이 아니다.
Research Question을 검증할 수 있는 적절한 데이터와 분석방법을 설계하는 것이다.
전체 흐름은 다음과 같다.
Research Model → Hypothesis → Measurement → Population → Sample → Data Collection → Data Cleaning → Descriptive Statistics → Reliability & Validity → Hypothesis Testing → Interpretation
이를 더 간단하게 정리하면
누구를 조사할 것인가? → 무엇을 측정할 것인가? → 데이터는 믿을 수 있는가? → 어떤 방법으로 검증할 것인가? → 결과가 무엇을 의미하는가?
이다.
이제 데이터를 분석했다면 박사논문의 마지막 단계로 넘어간다.
분석결과를 단순히 표와 p값으로 제시하는 것이 아니라
Findings → Discussion → Theoretical Contribution → Practical Implication → Limitations → Future Research → Dissertation
으로 연결해야 한다.
따라서 제10강은 「박사논문은 어떻게 완성하는가? ― 연구결과·논의·기여·Proposal·심사까지」로 이어진다.
H2. 12. 참고문헌(References)
- 「Cochran, W. G. Sampling Techniques, 3rd ed.」
- 확률표본추출, 층화표본추출, 표본오차와 신뢰구간 등 표본설계의 기본원리를 체계적으로 다룬 대표적인 통계학 문헌이다. 부동산경영 연구에서 모집단으로부터 대표성 있는 표본을 설계하는 데 중요한 이론적 기반이 된다. Wiley 공식 자료에서 제3판과 서지정보를 확인하였다.
- 바로가기: Wiley 공식 도서 페이지
- 「Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. Multivariate Data Analysis.」
- 회귀분석, 요인분석, 다변량 분석 및 구조모형 등 경영학 실증연구에 필요한 분석방법을 체계적으로 이해하는 데 활용되는 대표적인 방법론 문헌이다.
- 바로가기: Cengage 공식 홈페이지
- 「Cohen, J. Statistical Power Analysis for the Behavioral Sciences, 2nd ed.」
- 효과크기(Effect Size), 통계적 검정력(Statistical Power), 유의수준 및 표본크기의 관계를 체계화한 고전적인 방법론 문헌으로 연구 시작 전 적절한 표본크기를 계획하는 데 중요한 근거가 된다.
- 바로가기: Routledge 공식 도서 페이지
- 「Kline, R. B. (2023). Principles and Practice of Structural Equation Modeling, 5th ed.」
- CFA와 SEM의 기본원리, 모형설정과 평가 및 구조적 관계의 해석을 체계적으로 설명하는 대표적인 구조방정식 방법론 문헌이다. Guilford 공식 자료에서 제5판이 2023년에 출판되었으며 covariance-based SEM, structural causal model, composite SEM 등을 다루는 것을 확인하였다.
- 바로가기: Guilford Press 공식 도서 페이지
- 「Hayes, A. F. (2022). Introduction to Mediation, Moderation, and Conditional Process Analysis: A Regression-Based Approach, 3rd ed.」
- 회귀분석을 기반으로 직접효과·간접효과·매개효과·조절효과와 조건부 과정분석을 체계적으로 설명한다. 제3판은 PROCESS를 활용한 SPSS·SAS·R 분석까지 다루고 있다.
- 바로가기: Guilford Press 공식 도서 페이지
- 「Field, A. Discovering Statistics Using IBM SPSS Statistics.」
- 기술통계, 데이터 점검, 통계적 가정, 상관·회귀분석 및 다양한 통계기법을 SPSS와 연결하여 설명하는 실증분석 참고문헌으로, 부동산 설문자료의 정제와 통계분석 과정에 활용할 수 있다.
- 바로가기: SAGE Publications 공식 홈페이지
- 「Little, R. J. A., & Rubin, D. B. Statistical Analysis with Missing Data.」
- 결측자료의 발생 메커니즘과 결측치 처리 및 통계적 추론방법을 체계적으로 다루는 대표적인 방법론 문헌이다. 부동산 설문이나 거래자료 분석에서 결측치 처리방법을 결정할 때 중요한 참고자료다.
- 바로가기: Wiley 공식 홈페이지
- 「Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). “Common Method Biases in Behavioral Research: A Critical Review of the Literature and Recommended Remedies.” Journal of Applied Psychology, 88(5), 879–903.」
- 동일 응답자와 동일 측정방식에서 발생할 수 있는 Common Method Bias의 원인과 통제방법을 검토한 대표 연구다. 부동산경영 설문연구에서도 설문설계 단계부터 공통방법편의를 관리해야 한다는 중요한 방법론적 근거가 된다.
- 바로가기: APA PsycNet 공식 논문 페이지
- 「Creswell, J. W., & Creswell, J. D. Research Design: Qualitative, Quantitative, and Mixed Methods Approaches.」
- 연구문제 → 연구질문 → 연구설계 → 자료수집 → 분석 → 해석으로 이어지는 전체 연구과정을 질적·양적·혼합연구 관점에서 체계적으로 이해하는 데 활용되는 대표적인 연구방법론 문헌이다.
- 바로가기: SAGE Publications 공식 도서 페이지
-
[실무 유의사항]
- 표본설계는 모집단 정의 → 표본추출방법 결정 → 표본크기 산정 → 자료수집 순으로 일관되게 설계해야 한다.
- 설문자료는 본 분석 전에 결측치 → 이상치 → 정규성 → 기술통계 → 신뢰도·타당도 순으로 데이터 품질을 점검하는 것이 중요하다.
- CFA·SEM을 사용할 때는 표본크기만 기계적으로 적용하기보다 모형의 복잡성, 추정방법, 자료분포와 검정력을 함께 고려해야 한다.
- 공통방법편의는 통계분석 단계에서만 확인하기보다 설문 문항과 응답절차를 설계하는 단계에서부터 예방하는 것이 중요하