H1. 부동산 경영(REM) 부동산 데이터, 숫자만 보면 놓친다: 기술통계부터 왜도·첨도·이상치·결측치까지 제대로 읽는 법 (공인중개사 30년 실무 경험)
부제: 토지가격·임대료·공실률·수익률 데이터를 회귀분석하기 전에 평균·중앙값·표준편차·분포·왜도·첨도·이상치·결측치로 진단하는 부동산경영 박사논문 데이터 분석 실전
본 글은 국내외 선행연구, 통계학 및 연구방법론, 공공기관 자료와 공인중개사 30년 실무 경험을 바탕으로 작성한 논문형 연구 블로그입니다. 컴퓨터공학 · 부동산학 · 경영학 · 신학 · 경영학 박사과정 · Golf Teaching Pro
H2. 0. 초록(Abstract)
박사논문에서 연구모형을 만들고 연구가설을 설정했다고 해서 바로 회귀분석을 실행하는 것은 바람직하지 않다.
실증분석의 신뢰성은 분석기법의 복잡성보다 먼저 데이터가 어떠한 상태에 있는지를 정확하게 파악하는 데서 시작된다.
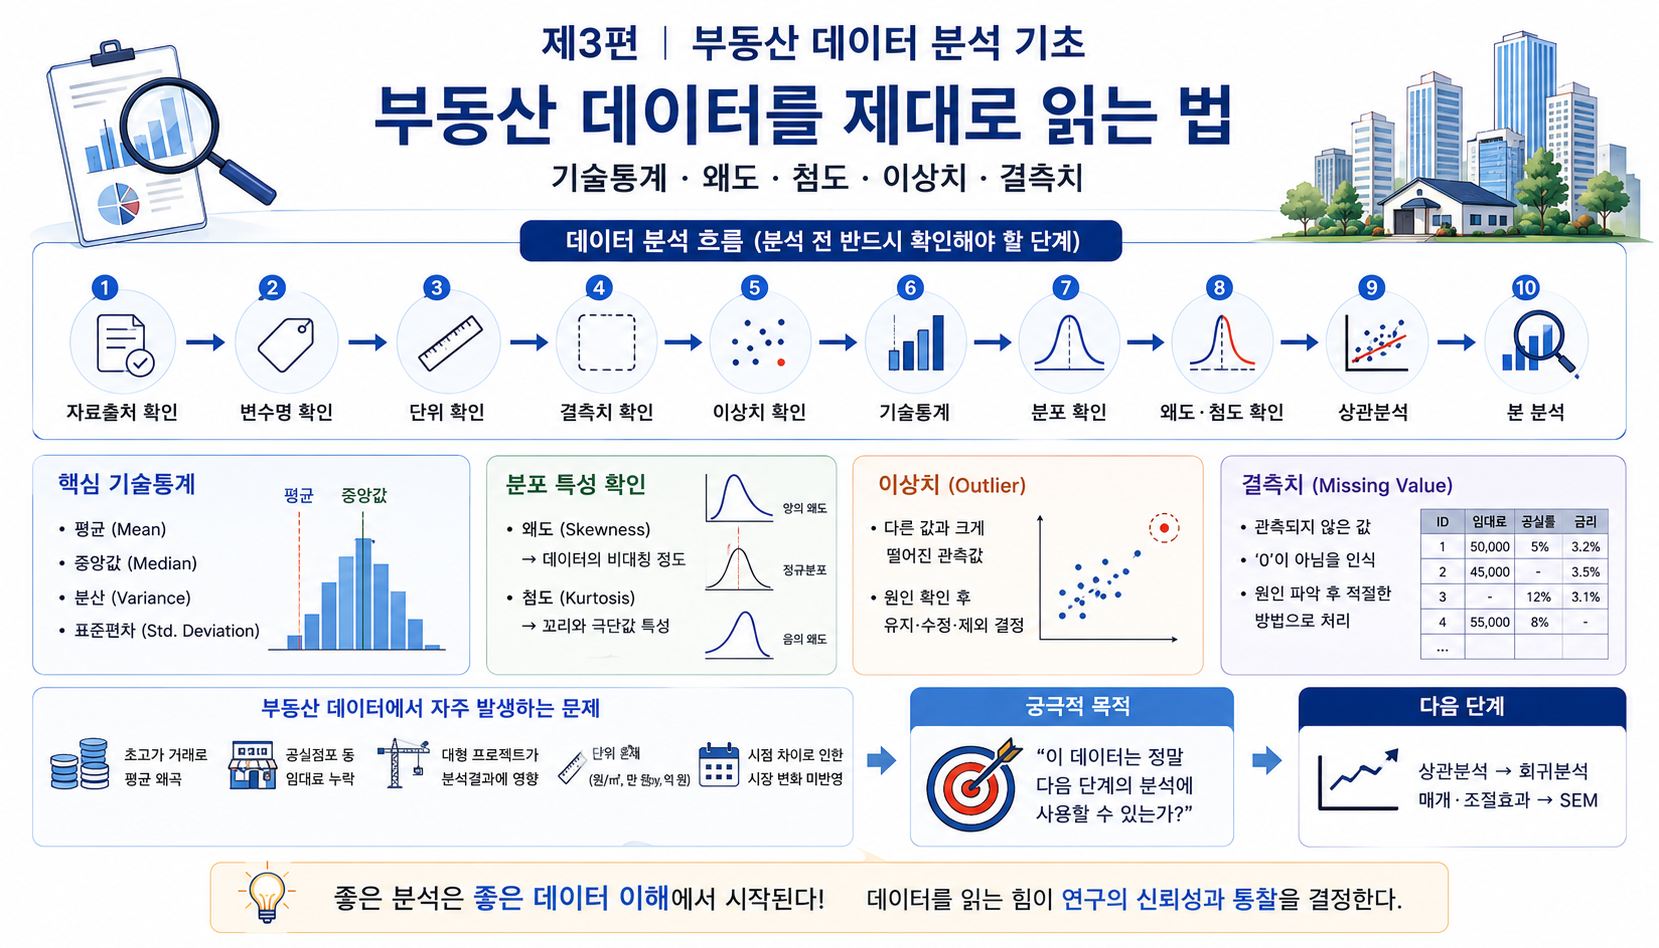
따라서 연구자는 데이터를 확보한 직후 다음과 같은 흐름으로 접근할 필요가 있다.
자료출처 확인 → 변수명 확인 → 단위 확인 → 결측치 확인 → 이상치 확인 → 기술통계 → 분포 확인 → 왜도·첨도 확인 → 상관분석 → 본 분석
이 순서가 중요한 이유는 데이터 자체에 문제가 있는데도 곧바로 회귀분석이나 구조방정식모형(SEM)을 실행하면 그 결과 역시 왜곡될 수 있기 때문이다.
부동산 데이터에는 이러한 문제가 특히 자주 발생할 수 있다.
예를 들어 토지가격은 일부 초고가 거래에 의해 평균이 크게 상승할 수 있으며, 상가 임대료 자료에는 공실점포의 임대료가 누락될 수 있고, 개발사업 자료에서는 사업규모가 매우 큰 몇 개 프로젝트가 전체 분석결과에 상당한 영향을 줄 수도 있다.
또한 동일한 가격자료라도
원/㎡, 만 원/py, 억 원
처럼 단위가 다를 수 있으며, 2020년 가격과 2026년 가격을 단순하게 같은 시장조건으로 비교하면 시간에 따른 시장 변화가 충분히 반영되지 않을 수 있다.
기술통계(Descriptive Statistics)는 이러한 데이터를 요약하고 연구자가 자료의 성격을 이해하도록 도와주는 첫 번째 분석단계이다.
NIST는 탐색적 자료분석(Exploratory Data Analysis)의 목적을 자료의 특성을 파악하고 분포·산포·왜도·이상치 등을 분석하여 데이터에 대한 통찰을 얻는 과정으로 설명한다.
본 글에서는 평균(Mean), 중앙값(Median), 분산(Variance), 표준편차(Standard Deviation), 왜도(Skewness), 첨도(Kurtosis), 이상치(Outlier), 결측치(Missing Value)를 부동산 실무자료와 연결하여 설명한다.
궁극적인 목적은 통계수치를 암기하는 데 있지 않다.
“이 데이터는 정말 다음 단계의 분석에 사용할 수 있는가?”
라는 연구자의 판단능력을 기르는 데 있다.
H2. 1. 서론(Introduction)
H3. 1.1 데이터를 받았다고 바로 회귀분석하면 안 되는 이유
박사과정에서 통계를 공부하다 보면 연구자가 가장 관심을 갖는 숫자는 흔히 p값이나 회귀계수이다.
그러나 그보다 먼저 확인해야 할 것이 있다.
분석에 사용한 데이터가 정상적인가?
예를 들어 어떤 연구에서
광역교통 접근성(X) → 투자성과(Y)
의 회귀분석 결과가 유의하게 나타났다고 가정하자.
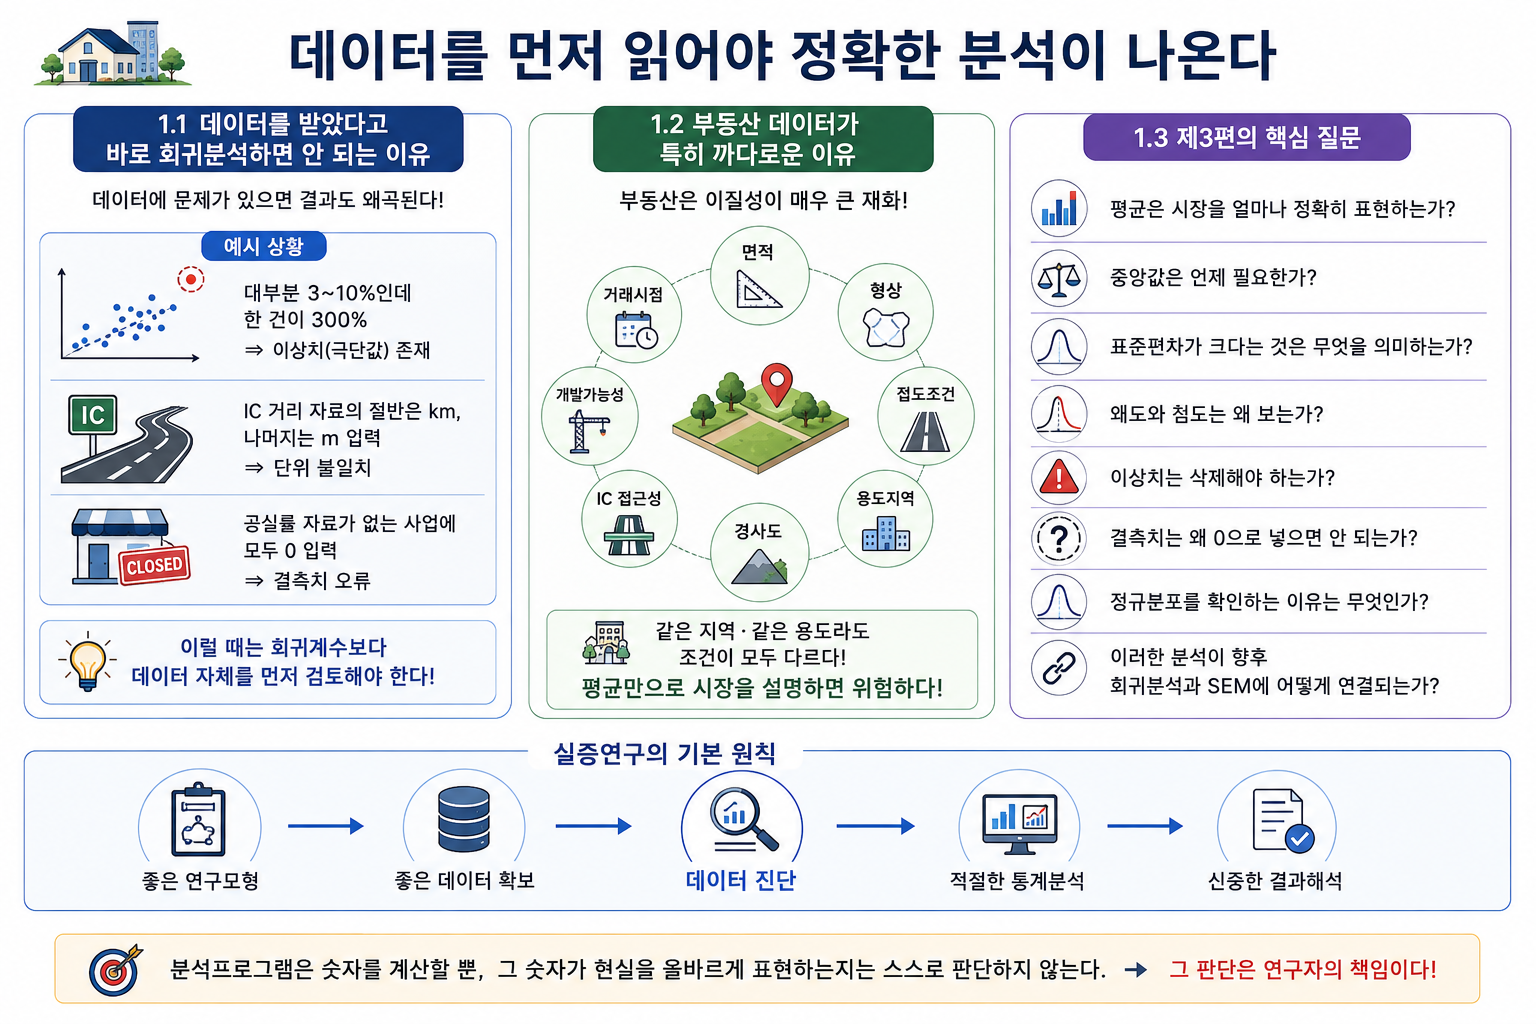
그런데 투자성과 변수의 대부분이 3~10%인데 단 한 개의 사업이 300%라는 값을 가지고 있다면 어떻게 해야 하는가?
또는 IC 거리 자료의 절반은 km이고 나머지는 m로 입력되어 있다면 어떻게 되는가?
혹은 공실률 자료가 없는 사업에 모두 0을 입력하였다면 어떠한 문제가 발생하는가?
이러한 상황에서는 회귀계수보다 데이터 자체를 먼저 검토해야 한다.
따라서 실증연구의 기본원칙은 다음과 같다.
좋은 연구모형 → 좋은 데이터 확보 → 데이터 진단 → 적절한 통계분석 → 신중한 결과해석
분석프로그램은 입력된 숫자를 계산하지만 그 숫자가 현실을 올바르게 표현하는지를 스스로 판단하지는 않는다.
그 판단은 연구자의 책임이다.
H3. 1.2 부동산 데이터가 특히 까다로운 이유
부동산은 이질성이 매우 큰 재화이다.
같은 지역의 토지라 하더라도
면적
형상
접도조건
용도지역
경사도
IC 접근성
개발가능성
거래시점
이 서로 다르다.
같은 상가라고 하더라도 층, 위치, 전면폭, 업종, 유동인구와 공실기간이 다르다.
따라서 부동산 데이터에서 단순 평균만 계산하고 시장 전체를 설명하는 것은 위험할 수 있다.
부동산 연구자는 숫자와 함께 그 숫자를 만들어낸 현장조건을 이해해야 한다.
H3. 1.3 제3편의 핵심 질문
이번 편에서는 다음 질문에 답하고자 한다.
평균은 시장을 얼마나 정확히 표현하는가?
중앙값은 언제 필요한가?
표준편차가 크다는 것은 무엇을 의미하는가?
왜도와 첨도는 왜 보는가?
이상치는 삭제해야 하는가?
결측치는 왜 0으로 넣으면 안 되는가?
정규분포를 확인하는 이유는 무엇인가?
그리고 이러한 분석이 향후 회귀분석과 SEM에 어떻게 연결되는가?
H2. 2. 기술통계(Descriptive Statistics)란 무엇인가
H3. 2.1 기술통계는 데이터를 요약하는 첫 번째 언어이다
기술통계는 수집한 데이터를 요약하고 그 특징을 이해하기 위한 통계방법이다.
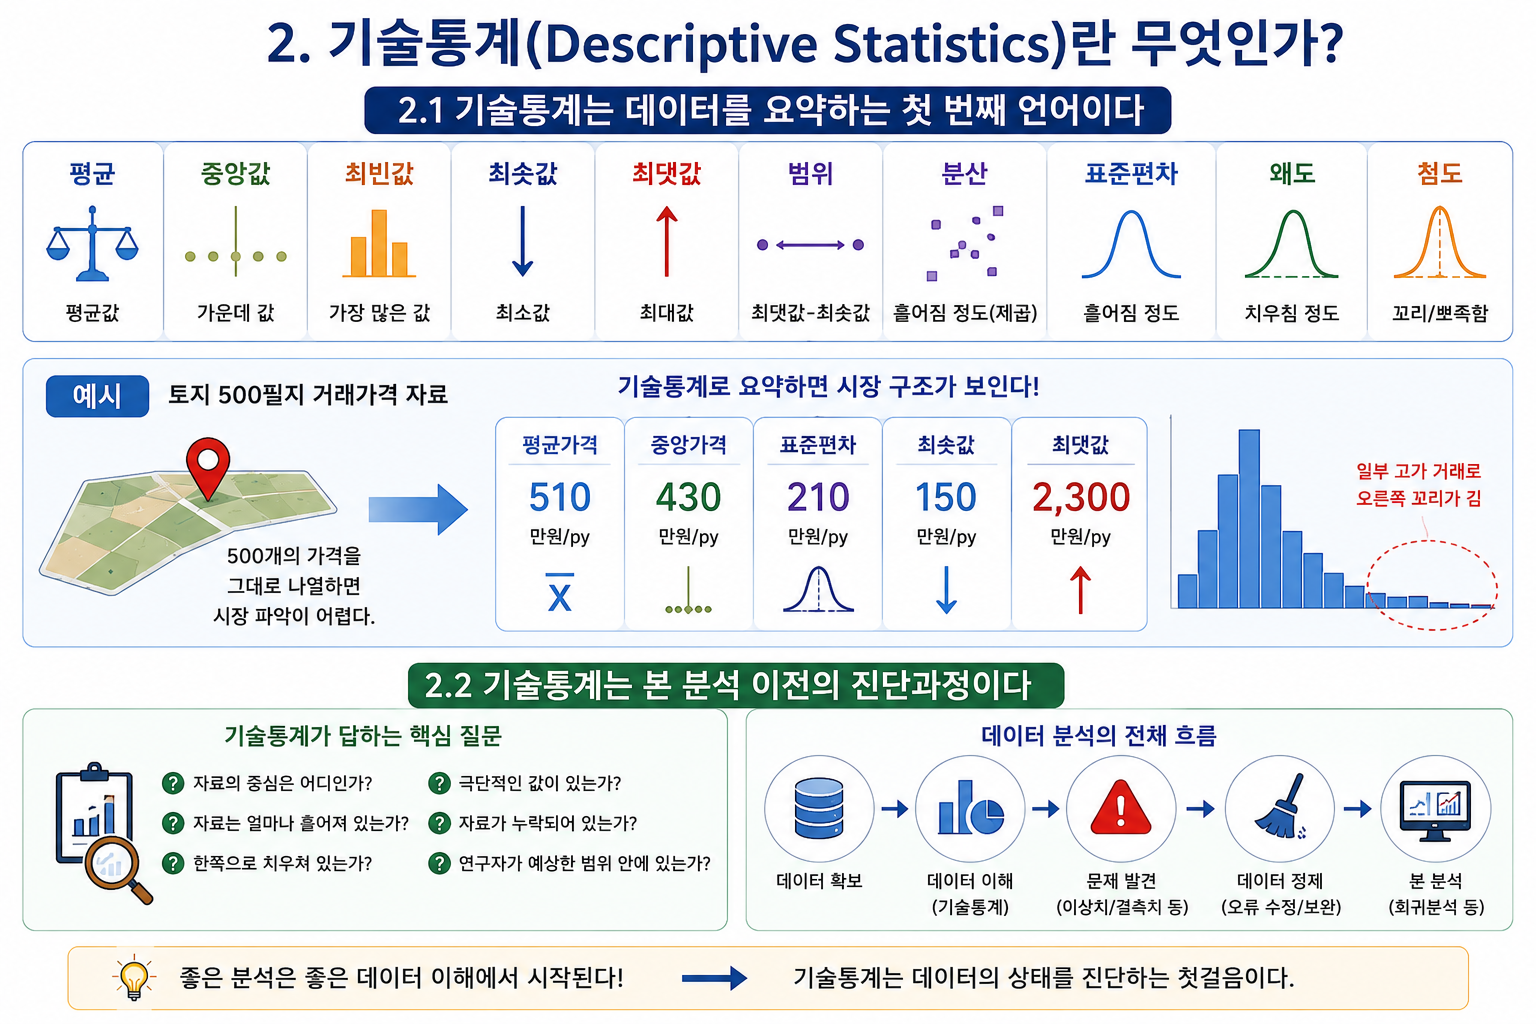
대표적인 항목은 다음과 같다.
평균
중앙값
최빈값
최솟값
최댓값
범위
분산
표준편차
왜도
첨도
예를 들어 토지 500필지의 거래가격 자료가 있다고 하자.
500개의 가격을 그대로 나열해서는 시장을 한눈에 파악하기 어렵다.
그러나
평균가격 510만 원/py
중앙가격 430만 원/py
표준편차 210만 원/py
최솟값 150만 원/py
최댓값 2,300만 원/py
이라고 요약하면 시장의 구조가 조금씩 보이기 시작한다.
H3. 2.2 기술통계는 본 분석 이전의 진단과정이다
기술통계의 목적은 단순히 논문에 표 하나를 넣기 위한 것이 아니다.
다음 질문에 답하기 위한 과정이다.
자료의 중심은 어디인가?
자료는 얼마나 흩어져 있는가?
한쪽으로 치우쳐 있는가?
극단적인 값이 있는가?
자료가 누락되어 있는가?
연구자가 예상한 범위 안에 있는가?
따라서 기술통계는
데이터 확보 → 데이터 이해 → 문제 발견 → 데이터 정제 → 본 분석
을 연결하는 핵심 단계이다.
H2. 3. 평균·중앙값·최빈값을 함께 봐야 하는 이유
H3. 3.1 평균(Mean)
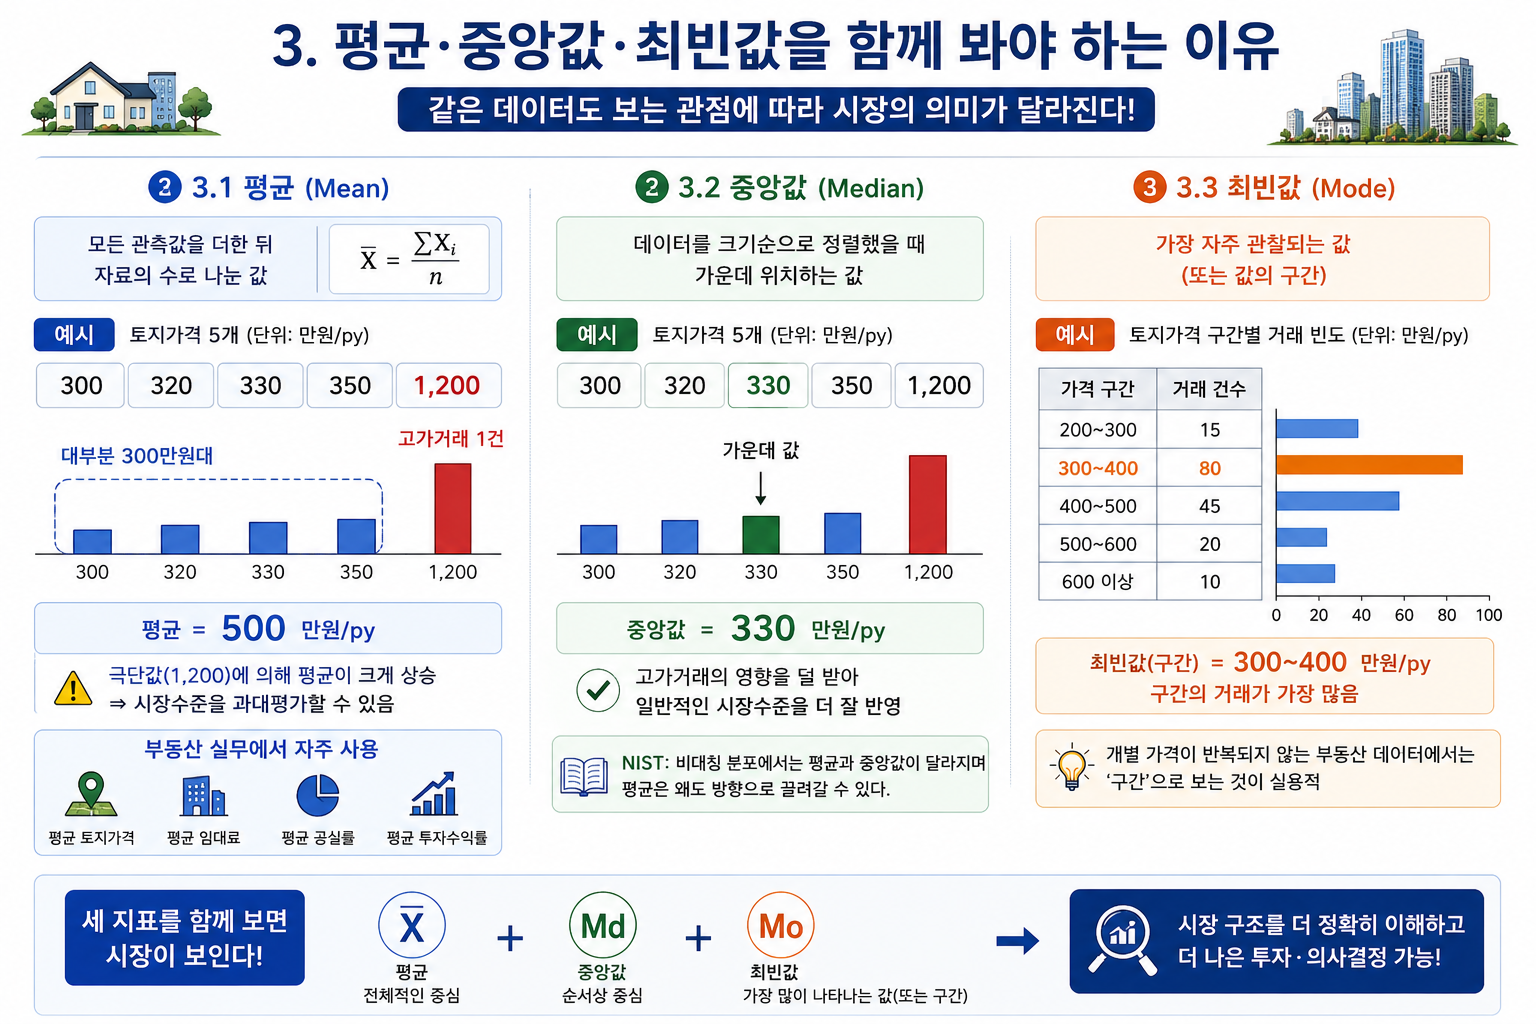
평균은 모든 관측값을 더한 뒤 자료의 수로 나눈 값이다.
표본평균은 다음과 같이 표현할 수 있다.
X̄ = ΣXi / n
부동산 실무에서는
평균 토지가격
평균 임대료
평균 공실률
평균 투자수익률
등으로 자주 사용된다.
그러나 평균은 극단적인 값의 영향을 받을 수 있다.
예를 들어 5개의 토지가격이 다음과 같다고 하자.
300 → 320 → 330 → 350 → 1,200만 원/py
대부분 300만 원대인데 마지막 하나의 고가거래가 평균을 크게 끌어올린다.
따라서 평균 하나만 보면 일반적인 시장수준을 실제보다 높게 평가할 수도 있다.
H3. 3.2 중앙값(Median)
중앙값은 데이터를 크기순으로 정렬했을 때 가운데 위치하는 값이다.
앞 사례에서는
300 → 320 → 330 → 350 → 1,200
가운데 값인 330만 원/py가 중앙값이다.
NIST도 비대칭 분포에서는 평균과 중앙값이 달라지며 평균이 왜도의 방향으로 끌려갈 수 있다고 설명한다.
따라서 부동산 가격처럼 고가 거래가 존재하는 데이터에서는
평균 + 중앙값
을 함께 보는 것이 유용하다.
H3. 3.3 최빈값(Mode)
최빈값은 가장 자주 관찰되는 값이다.
부동산 개별 거래가격처럼 동일한 값이 반복되지 않는 자료에서는 정확한 숫자보다 가격구간으로 분석하는 것이 실용적일 수 있다.
예를 들어
300~400만 원/py 구간 거래가 가장 많다
는 방식이다.
따라서 시장을 이해할 때
평균 = 전체적인 중심
중앙값 = 순서상 중심
최빈값 = 가장 많이 나타나는 값 또는 구간
으로 구분해 볼 수 있다.
NIST는 왜도가 있는 분포를 요약할 때 평균·중앙값·최빈값이 서로 다른 중심 정보를 제공하므로 여러 중심지표를 함께 살펴볼 수 있다고 설명한다.
H2. 4. 분산과 표준편차는 시장의 변동성을 보여준다
H3. 4.1 평균이 같아도 전혀 다른 시장일 수 있다
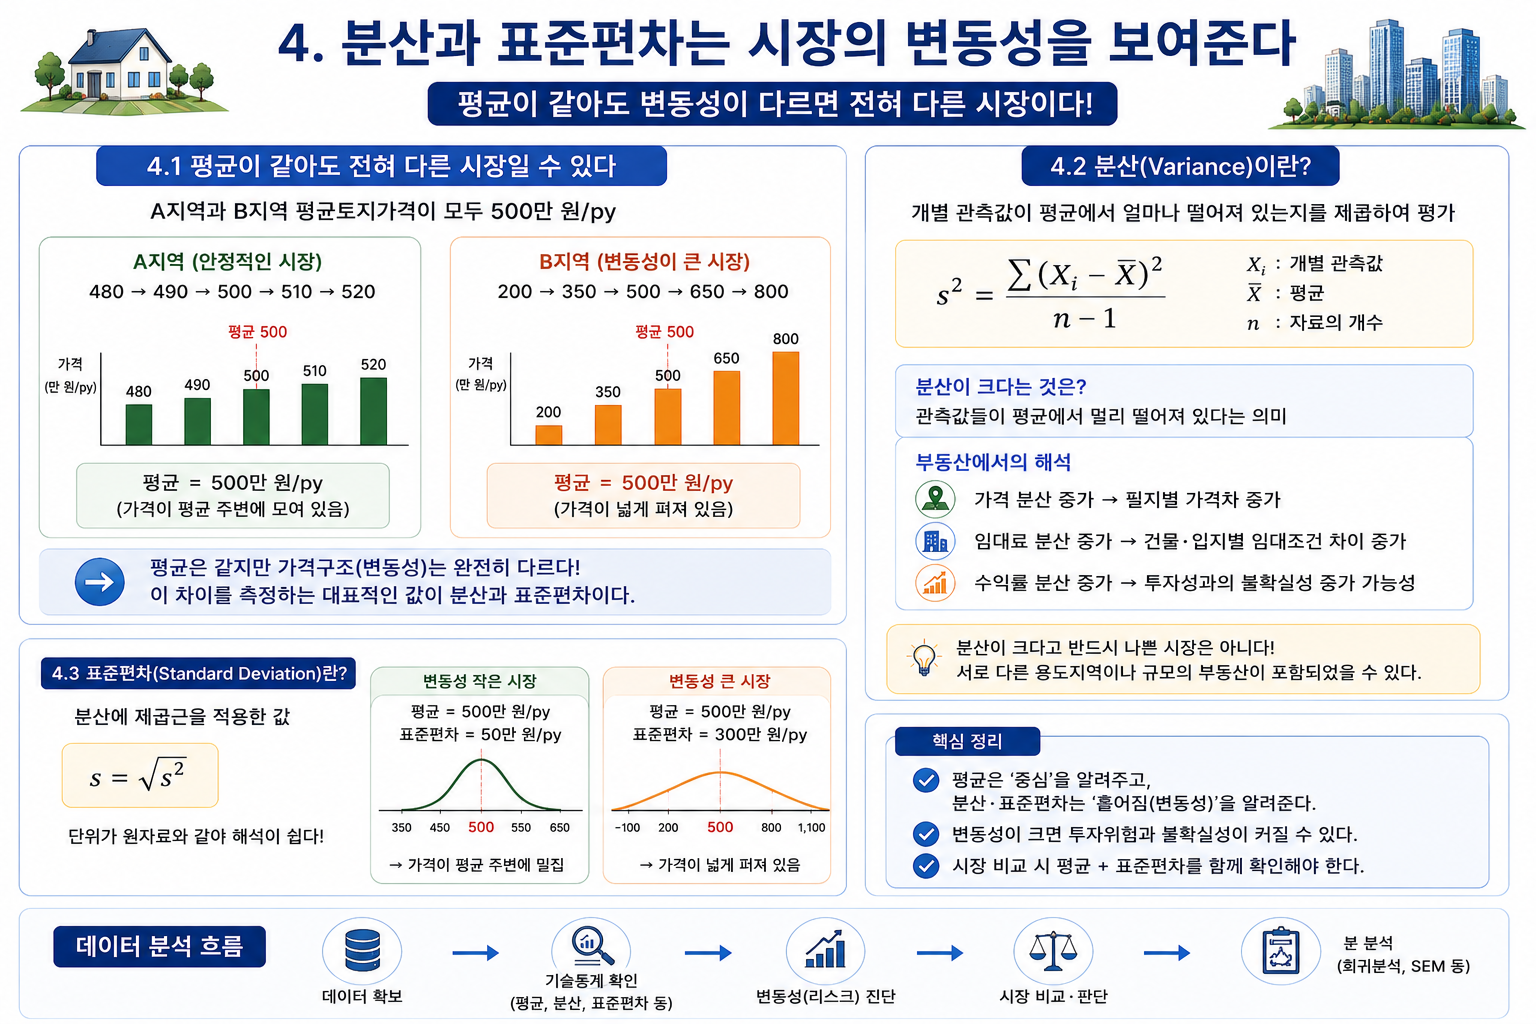
A지역과 B지역 평균토지가격이 모두 500만 원/py라고 가정해 보자.
A지역:
480 → 490 → 500 → 510 → 520
B지역:
200 → 350 → 500 → 650 → 800
평균은 동일하지만 시장의 가격구조는 전혀 다르다.
A지역은 가격이 평균 주변에 모여 있고 B지역은 넓게 퍼져 있다.
이 차이를 측정하는 대표적인 값이 분산과 표준편차이다.
H3. 4.2 분산(Variance)
표본분산은 개별 관측값이 평균에서 얼마나 떨어져 있는지를 제곱하여 평가한다.
s² = Σ(Xi − X̄)² / (n − 1)
분산이 크다는 것은 관측값들의 차이가 상대적으로 크다는 의미이다.
부동산에서는 다음과 같이 해석할 수 있다.
가격 분산 증가 → 필지별 가격차 증가
임대료 분산 증가 → 건물·입지별 임대조건 차이 증가
수익률 분산 증가 → 투자성과의 불확실성 증가 가능성
그러나 분산이 크다고 반드시 나쁜 시장이라는 의미는 아니다.
서로 다른 용도지역이나 규모의 부동산이 한 데이터에 포함되어 있기 때문일 수도 있다.
H3. 4.3 표준편차(Standard Deviation)
표준편차는 분산에 제곱근을 적용한 값이다.
s = √s²
표준편차의 장점은 원자료와 같은 단위로 해석할 수 있다는 데 있다.
예를 들어
평균 토지가격 = 500만 원/py
표준편차 = 50만 원/py
라면
가격이 평균 주변에 비교적 밀집되어 있는 시장과
평균 토지가격 = 500만 원/py
표준편차 = 300만 원/py
인 시장은 동일하게 해석할 수 없다.
H2. 5. 데이터 분포(Distribution)를 확인해야 하는 이유
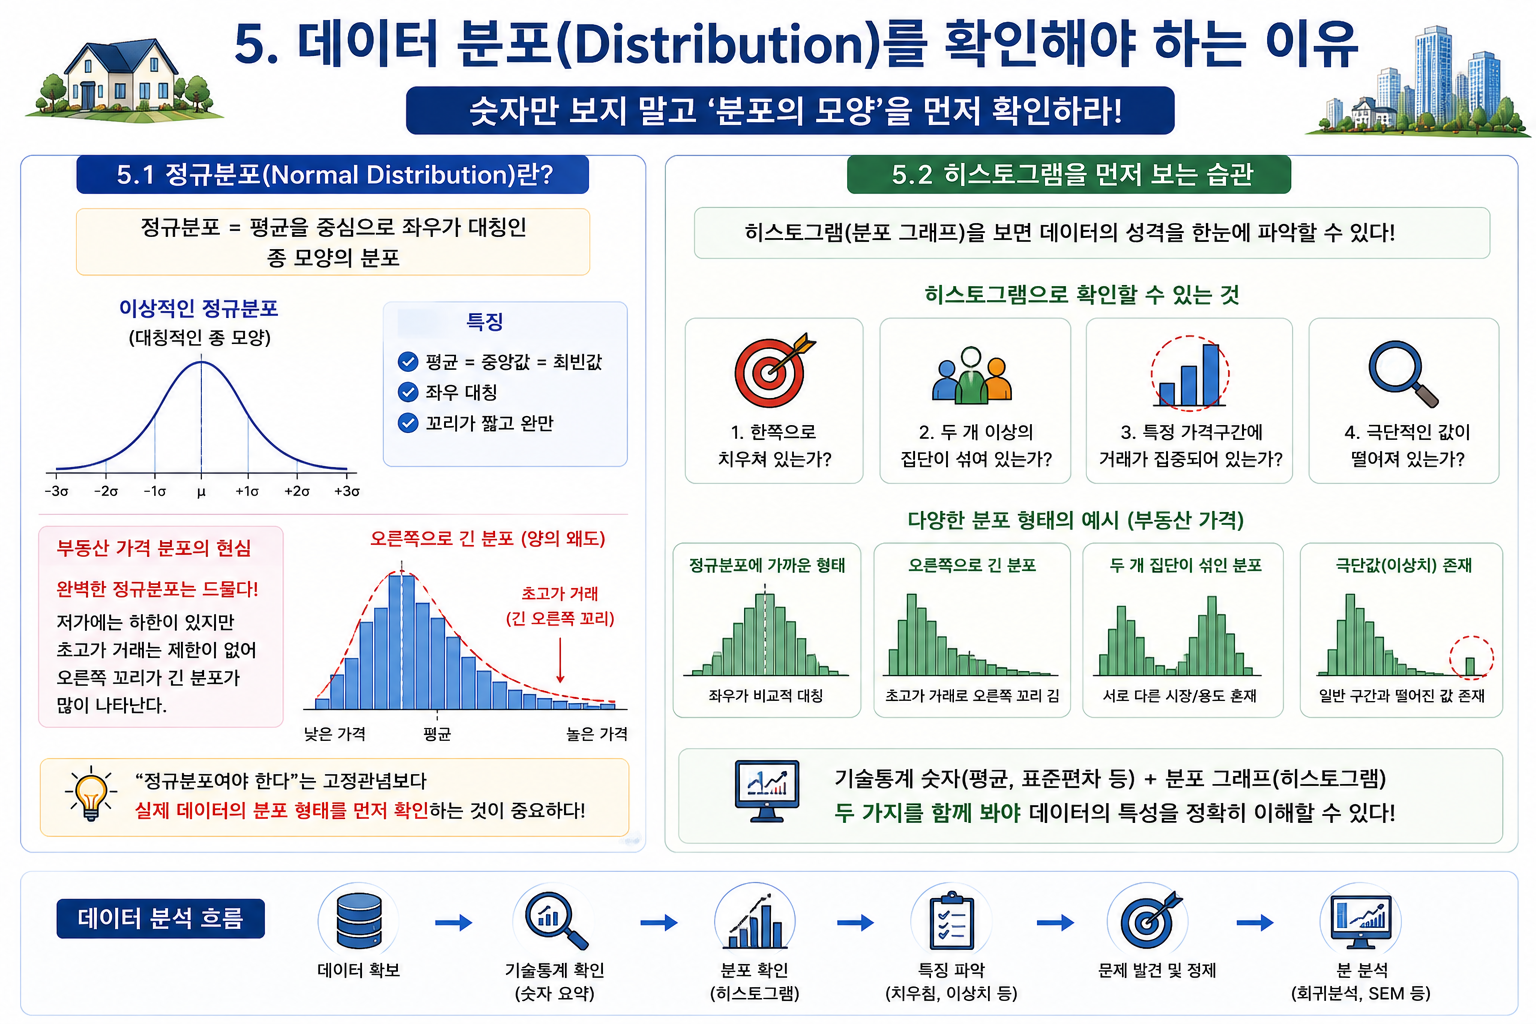
H3. 5.1 정규분포(Normal Distribution)
정규분포는 평균을 중심으로 좌우가 대칭적인 종 모양의 분포를 의미한다.
그러나 실제 부동산 가격은 완벽한 정규분포를 이루지 않는 경우가 많다.
저가 거래는 일정한 하한이 존재하는 반면 초고가 부동산은 큰 값을 가질 수 있기 때문에 오른쪽 꼬리가 긴 형태가 나타날 수 있다.
따라서 연구자는 “정규분포여야 한다”라고 기계적으로 생각하기보다 실제 자료가 어떤 형태를 가지고 있는지 먼저 확인해야 한다.
H3. 5.2 히스토그램을 먼저 보는 습관
숫자만 보는 것보다 분포 그래프를 함께 보는 것이 좋다.
예를 들어 히스토그램에서 다음을 확인할 수 있다.
자료가 한쪽으로 치우쳤는가?
두 개 이상의 집단이 섞여 있는가?
특정 가격구간에 거래가 집중되어 있는가?
극단적인 값이 떨어져 있는가?
즉
기술통계 숫자 + 그래프
를 함께 사용해야 데이터의 성격을 더 정확하게 이해할 수 있다.
H2. 6. 왜도(Skewness)를 이해하면 부동산 가격분포가 보인다
H3. 6.1 왜도란 무엇인가
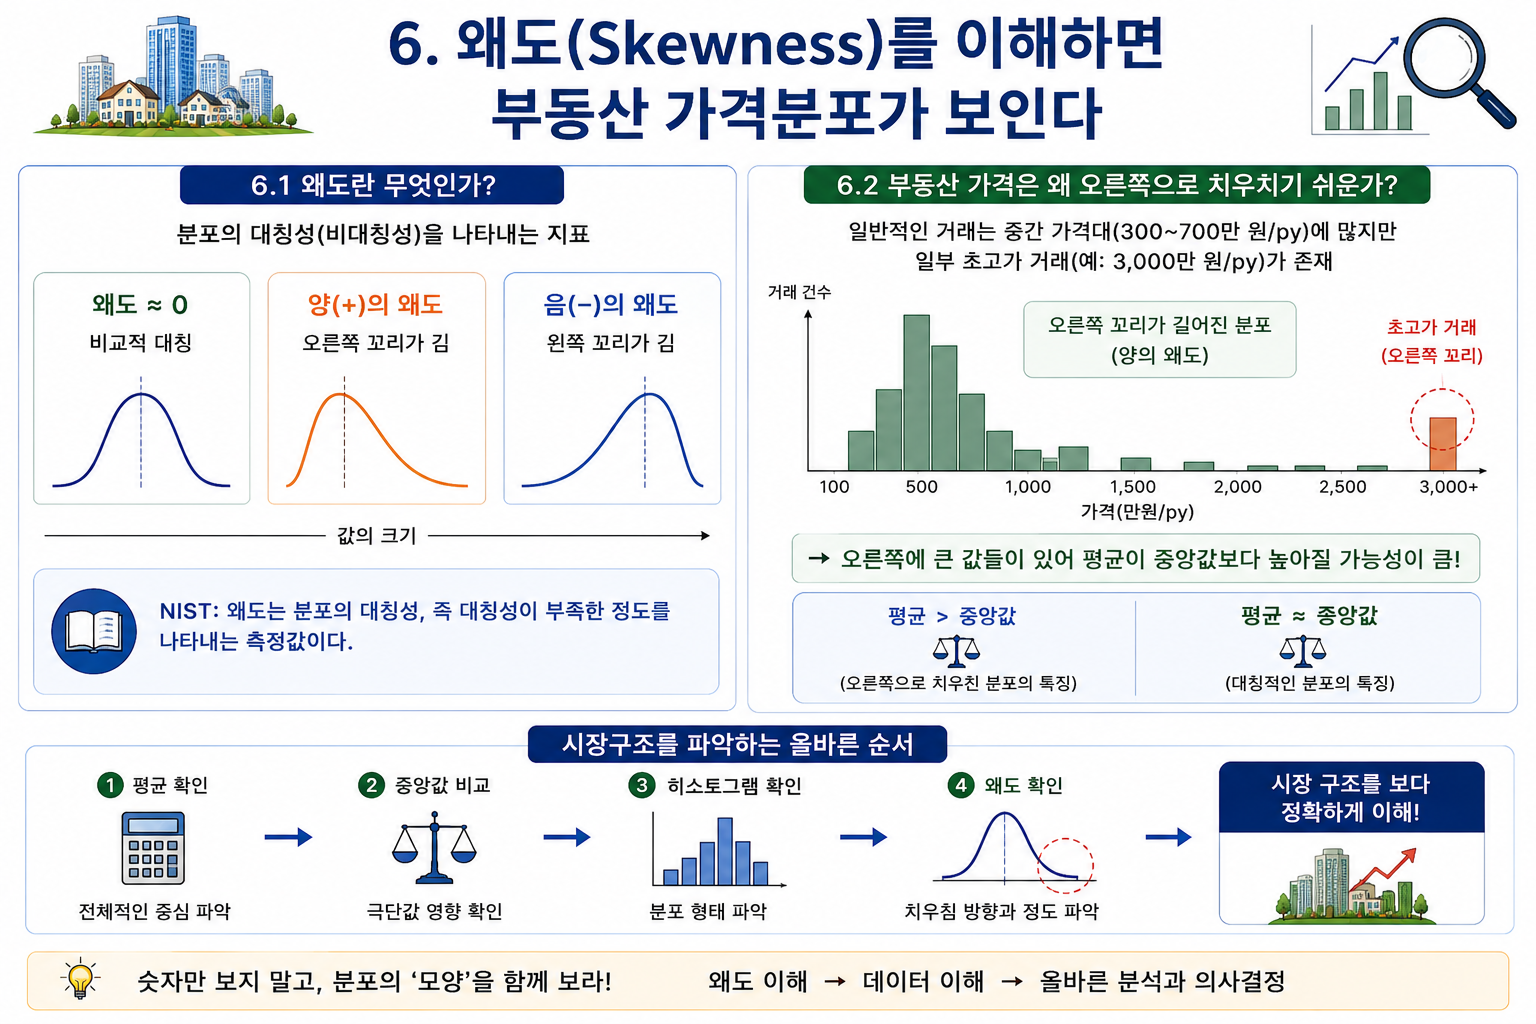
왜도는 자료분포의 대칭성 또는 비대칭성을 설명하는 지표이다.
NIST는 왜도를 분포의 대칭성, 더 정확하게는 대칭성 부족의 정도를 나타내는 측정값으로 설명한다.
쉽게 표현하면
왜도 ≈ 0 → 비교적 대칭
양(+)의 왜도 → 오른쪽 꼬리가 길다
음(-)의 왜도 → 왼쪽 꼬리가 길다
로 이해할 수 있다.
H3. 6.2 부동산 가격은 왜 오른쪽으로 치우치기 쉬운가
예를 들어 일반적인 토지거래가격이 300~700만 원/py인데 일부 대로변 상업용지가 3,000만 원/py에 거래될 수 있다.
이 경우 오른쪽에 큰 값들이 존재하면서 분포가 오른쪽으로 길어질 수 있다.
이러한 자료에서는 평균이 중앙값보다 높아질 가능성이 있다.
따라서
평균 확인 → 중앙값 비교 → 히스토그램 확인 → 왜도 확인
순으로 보면 시장구조를 보다 명확하게 파악할 수 있다.
H2. 7. 첨도(Kurtosis)는 무엇을 알려주는가
H3. 7.1 첨도를 단순히 봉우리 높이로만 이해하면 안 된다
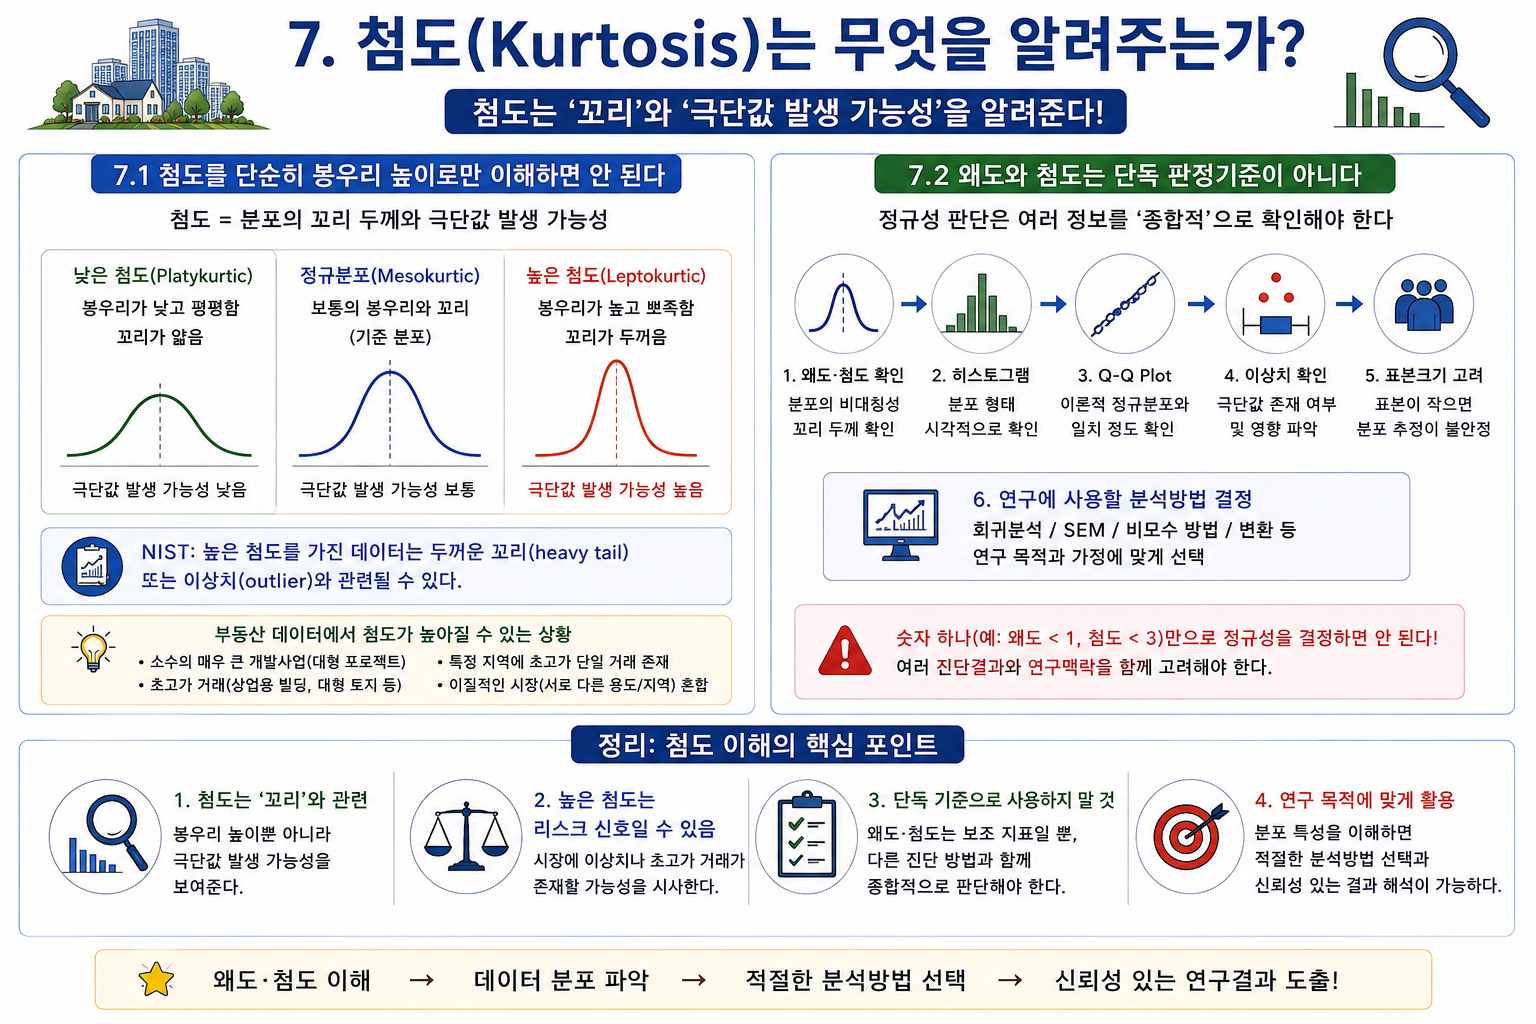
첨도를 단순히 “그래프가 얼마나 뾰족한가”라고 외우는 경우가 많다.
그러나 실제 해석에서는 분포의 꼬리 부분과 극단값 발생 가능성을 이해하는 것이 중요하다.
NIST는 높은 첨도를 가진 데이터가 두꺼운 꼬리 또는 이상치와 관련될 수 있다고 설명한다.
부동산 연구에서는 소수의 매우 큰 개발사업이나 초고가 거래가 존재할 때 첨도 값이 영향을 받을 수 있다.
H3. 7.2 왜도와 첨도는 단독 판정기준이 아니다
박사논문에서 흔히
왜도 몇 이하
첨도 몇 이하
와 같은 하나의 숫자만으로 정규성을 판정하려는 경우가 있다.
그러나 실제 데이터 진단에서는
왜도·첨도 → 히스토그램 → Q-Q Plot → 이상치 → 표본크기 → 연구에 사용할 분석방법
을 종합적으로 고려하는 것이 적절하다.
숫자 하나가 전체 연구설계를 대신해서는 안 된다.
H2. 8. 이상치(Outlier)는 삭제하기 전에 이유를 찾아야 한다
H3. 8.1 이상치란 무엇인가
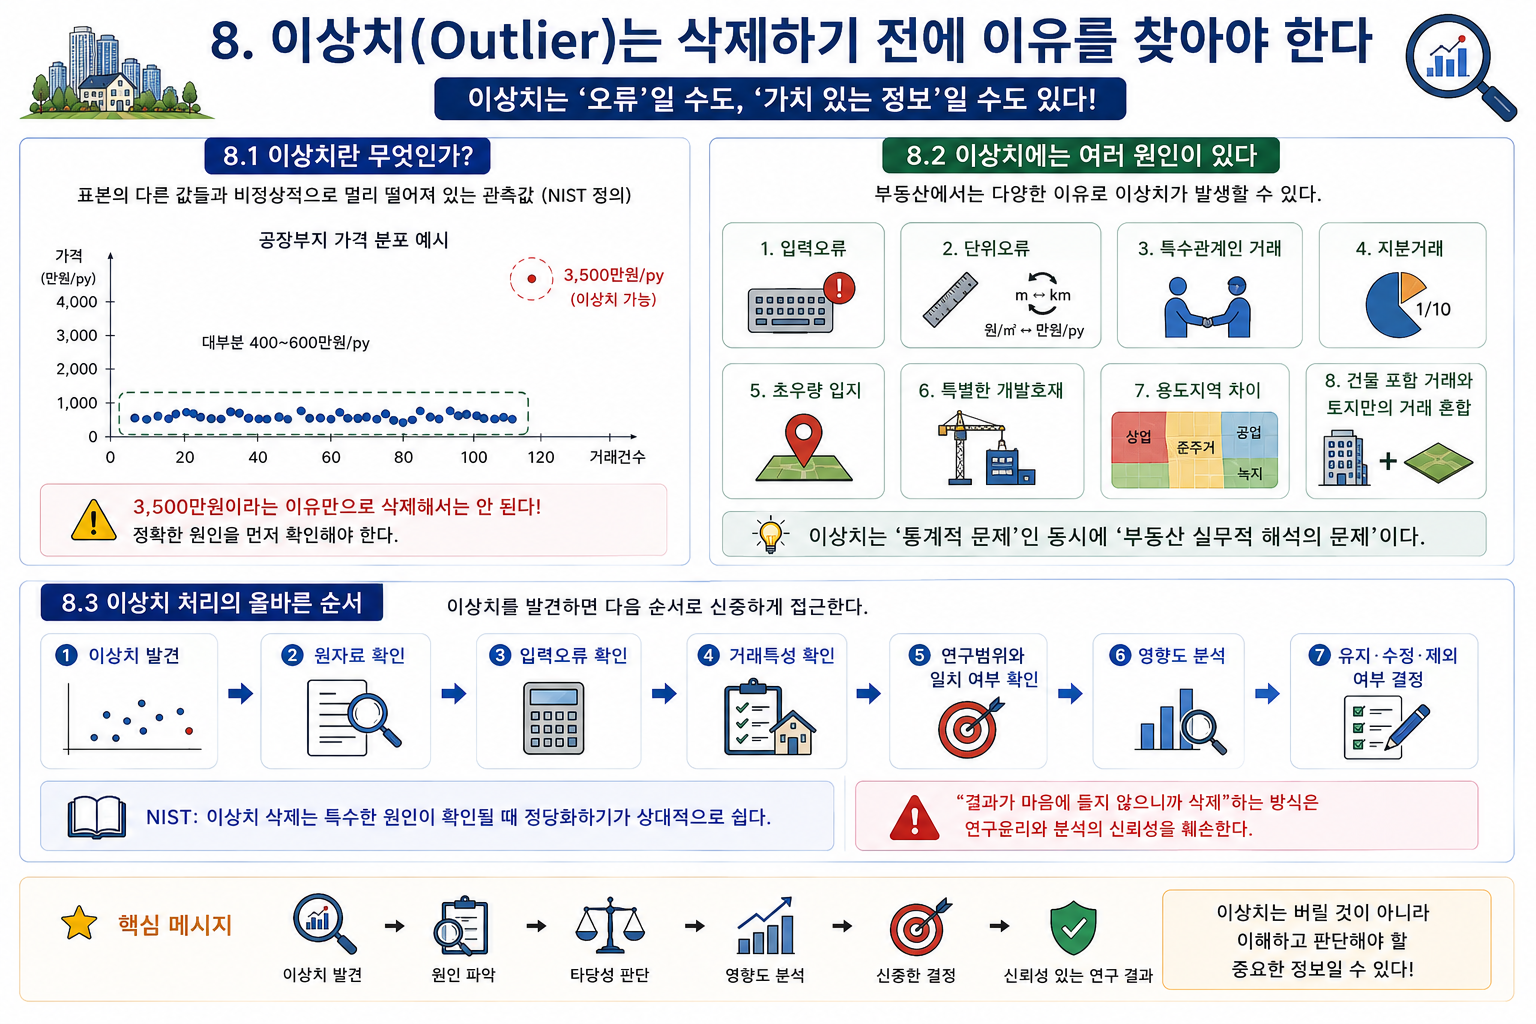
NIST는 이상치를 표본의 다른 값들과 비정상적으로 멀리 떨어져 있는 관측값으로 설명한다.
예를 들어 어느 공장부지 시장의 가격이 대부분
400~600만 원/py
인데 한 건이
3,500만 원/py
이라면 이상치 가능성을 검토할 수 있다.
그러나 3,500만 원이라는 이유만으로 삭제해서는 안 된다.
H3. 8.2 이상치에는 여러 원인이 있다
부동산에서 이상치는 다음과 같은 원인으로 발생할 수 있다.
입력오류
단위오류
특수관계인 거래
지분거래
초우량 입지
특별한 개발호재
용도지역 차이
건물 포함 거래와 토지만의 거래 혼합
즉 이상치는
통계적 문제
인 동시에
부동산 실무적 해석의 문제
이다.
H3. 8.3 이상치 처리의 올바른 순서
이상치를 발견하면 다음과 같은 가로 흐름으로 접근하는 것이 좋다.
이상치 발견 → 원자료 확인 → 입력오류 확인 → 거래특성 확인 → 연구범위와 일치 여부 확인 → 영향도 분석 → 유지·수정·제외 여부 결정
NIST 역시 이상치 삭제는 특수한 원인이 확인될 때 정당화하기가 상대적으로 쉽다는 점을 설명한다.
따라서
“결과가 마음에 들지 않으니까 삭제”
하는 방식은 연구윤리와 분석의 신뢰성을 훼손할 수 있다.
H2. 9. 결측치(Missing Value)는 0이 아니다
H3. 9.1 결측치의 기본 개념
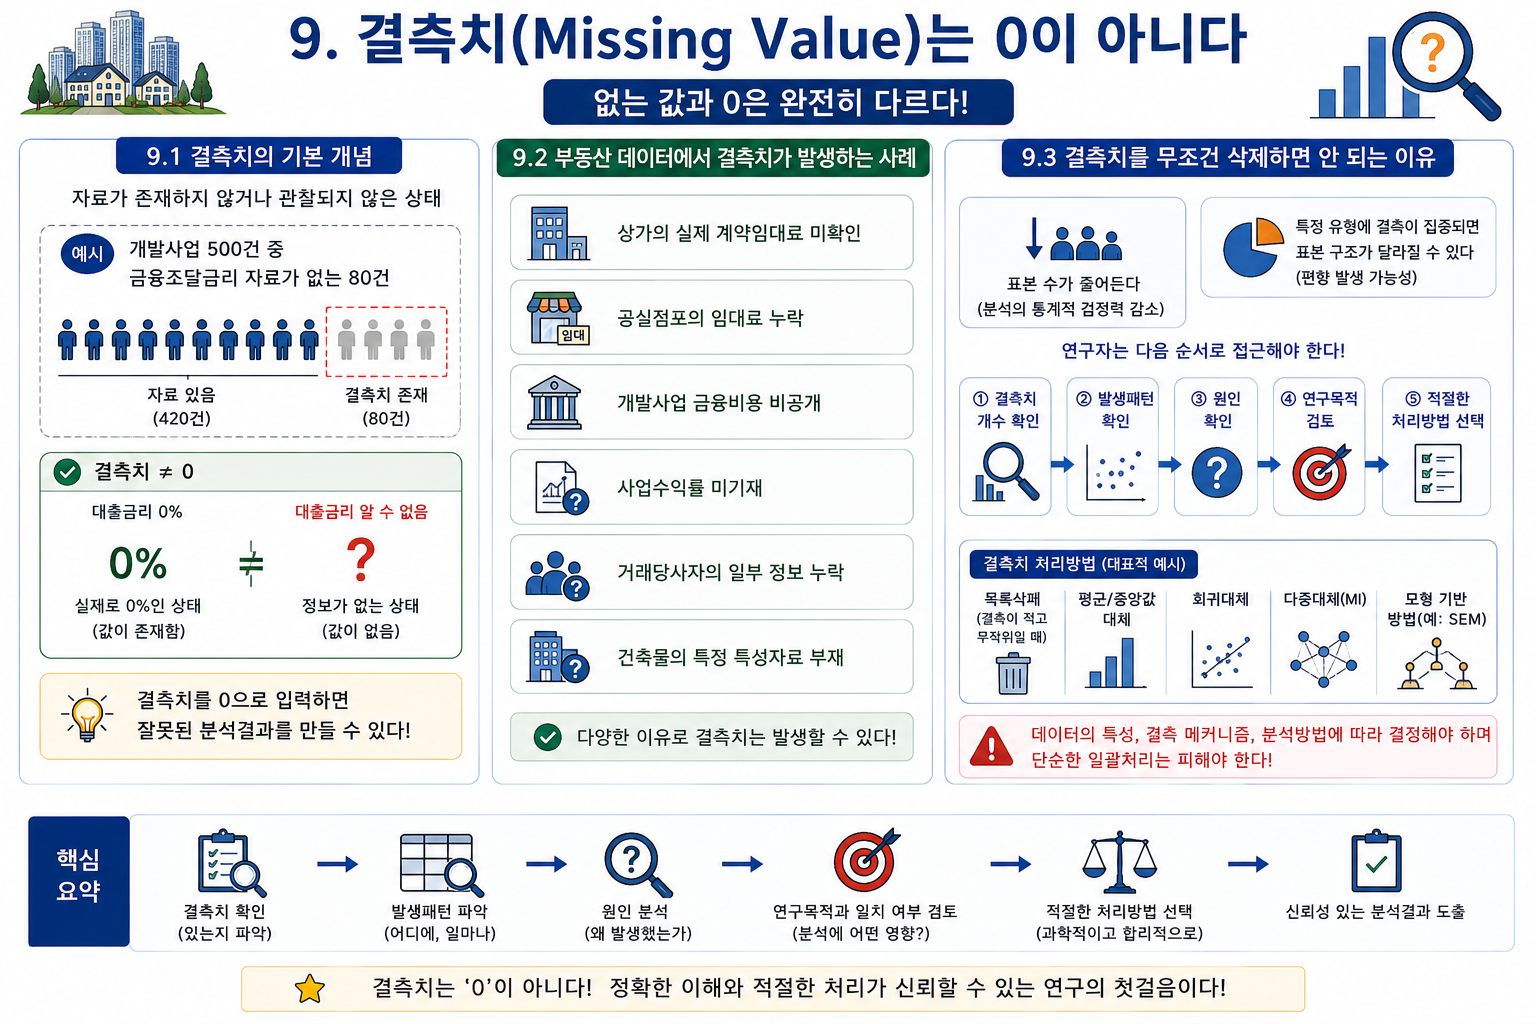
결측치는 자료가 존재하지 않거나 관찰되지 않은 상태이다.
예를 들어 개발사업 500건 가운데 80건의 금융조달금리 자료가 없다면 그 80건은 결측치가 존재하는 것이다.
여기서 가장 중요한 것은
결측치 ≠ 0
이라는 점이다.
대출금리가 0%인 것과
대출금리를 알 수 없는 것
은 완전히 다른 의미이다.
H3. 9.2 부동산 데이터에서 결측치가 발생하는 사례
상가의 실제 계약임대료 미확인
공실점포의 임대료 누락
개발사업 금융비용 비공개
사업수익률 미기재
거래당사자의 일부 정보 누락
건축물의 특정 특성자료 부재
등이 있다.
H3. 9.3 결측치를 무조건 삭제하면 안 되는 이유
결측자료를 모두 제거하면 표본 수가 줄어든다.
더 중요한 문제는 결측이 특정 유형에 집중되어 있을 경우 표본의 구조가 달라질 수 있다는 점이다.
따라서 연구자는
결측치 개수 확인 → 발생패턴 확인 → 원인 확인 → 연구목적 검토 → 적절한 처리방법 선택
의 순서로 접근해야 한다.
결측치 처리방법은 데이터의 특성, 결측 메커니즘과 분석방법에 따라 결정되어야 하며 단순한 일괄처리는 피하는 것이 좋다.
H2. 10. 핵심 통계 용어 정리(Statistical Terminology)
| 한글(한자) | 영어 원어·약어·IPA | 뜻 + 부동산 실무 의미 |
|---|---|---|
| 기술통계 (記述統計) |
Descriptive Statistics /dɪˈskrɪptɪv stəˈtɪstɪks/ |
가격·공실률 등 자료 요약 |
| 탐색적 자료분석 (探索的資料分析) |
Exploratory Data Analysis · EDA /ɪkˈsplɔːrətɔːri ˈdeɪtə əˈnæləsɪs/ |
가격분포·자료오류 탐색 |
| 평균 (平均) |
Mean /miːn/ |
평균 토지가격·임대료 |
| 중앙값 (中央値) |
Median /ˈmiːdiən/ |
극단값 영향을 덜 받는 중심값 |
| 최빈값 (最頻値) |
Mode /moʊd/ |
가장 자주 나타나는 값 |
| 분산 (分散) |
Variance /ˈveriəns/ |
가격이 퍼져 있는 정도 |
| 표준편차 (標準偏差) |
Standard Deviation · SD /ˈstændərd ˌdiːviˈeɪʃən/ |
가격·수익률의 변동 정도 |
| 분포 (分布) |
Distribution /ˌdɪstrɪˈbjuːʃən/ |
데이터가 퍼져 있는 형태 |
| 정규분포 (正規分布) |
Normal Distribution /ˈnɔːrməl ˌdɪstrɪˈbjuːʃən/ |
평균 중심의 대칭 분포 |
| 왜도 (歪度) |
Skewness /ˈskjuːnəs/ |
분포의 좌우 비대칭 정도 |
| 첨도 (尖度) |
Kurtosis /kɜːrˈtoʊsɪs/ |
꼬리·극단값 특성 확인 |
| 이상치 (異常値) |
Outlier /ˈaʊtlaɪər/ |
초고가·특수거래 등 확인 |
| 결측치 (缺測値) |
Missing Value /ˈmɪsɪŋ ˈvæljuː/ |
임대료·금리 등 누락자료 |
| 범위 (範圍) |
Range /reɪndʒ/ |
최고·최저 가격의 차이 |
| 사분위범위 (四分位範圍) |
Interquartile Range · IQR /ˌɪntərˈkwɔːrtaɪl reɪndʒ/ |
가운데 50% 자료의 범위 |
| 표준화점수 (標準化點數) |
Z-score · Z /ˈziː skɔːr/ |
평균에서 떨어진 정도 |
| 로그변환 (對數變換) |
Log Transformation /lɔːɡ ˌtrænsfərˈmeɪʃən/ |
치우친 가격자료 변환 |
H2. 11. 데이터 정제(Data Cleaning)는 왜 필요한가
H3. 11.1 데이터 정제는 결과를 예쁘게 만드는 작업이 아니다
데이터 정제는 자신이 원하는 결과를 얻기 위해 데이터를 조작하는 작업이 아니다.
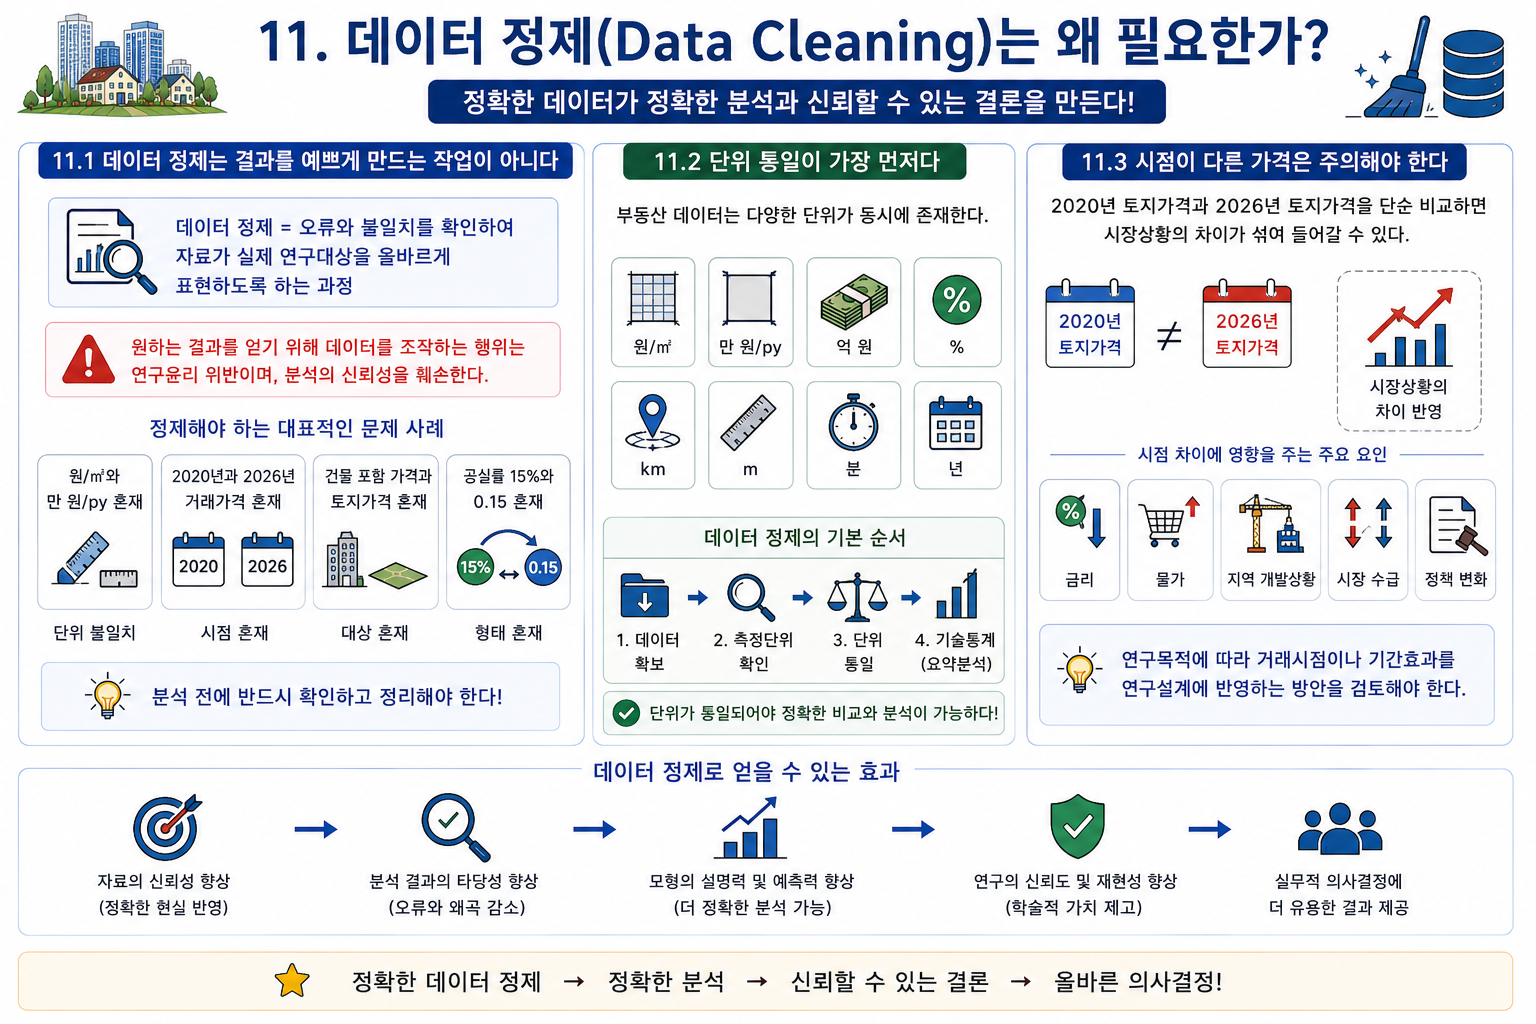
자료가 실제 연구대상을 올바르게 표현하도록 오류와 불일치를 확인하는 과정이다.
예를 들어
원/㎡와 만 원/py 혼재
2020년과 2026년 거래가격 혼재
건물 포함 가격과 토지가격 혼재
공실률 15%와 0.15 혼재
와 같은 문제가 존재한다면 분석 전에 정리해야 한다.
H3. 11.2 단위 통일이 가장 먼저다
부동산 데이터는 특히 단위가 다양하다.
원/㎡
만 원/py
억 원
%
km
m
분
년
등이 동시에 등장한다.
따라서
데이터 확보 → 측정단위 확인 → 단위 통일 → 기술통계
순서가 중요하다.
H3. 11.3 시점이 다른 가격은 주의해야 한다
2020년 토지가격과 2026년 토지가격을 단순하게 비교하면 시장상황의 차이가 섞여 들어갈 수 있다.
금리
물가
지역 개발상황
시장수급
정책변화
등이 달라질 수 있기 때문이다.
따라서 연구목적에 따라 거래시점이나 기간효과를 연구설계에 반영하는 방안을 검토해야 한다.
H2. 12. 회귀분석 전에 반드시 확인해야 할 데이터 흐름
연구자가 실제 자료를 받으면 다음과 같은 순서로 접근하는 것이 실용적이다.
자료출처 확인 → 변수명 확인 → 자료형 확인 → 측정단위 통일 → 결측치 확인 → 이상치 확인 → 평균·중앙값 확인 → 표준편차 확인 → 히스토그램 확인 → 왜도·첨도 확인 → 변수 간 관계 확인 → 본 분석
이 순서가 중요한 이유는 분석결과가 이상할 때 본 분석 자체의 문제인지 원자료의 문제인지 구별하기 쉬워지기 때문이다.
데이터를 충분히 이해하지 않고 회귀분석부터 실행하는 것은 부동산을 현장확인하지 않고 가격만 보고 계약하는 것과 비슷하다.
H2. 13. 실무 사례 연구(Case Study)
공인중개사 30년 실무 노트 (REM & Logistics Insights)
안녕하세요. 엑스포공인중개사사무소입니다.
경기도 광주시 곤지암읍, 도척면, 초월읍 등 수도권 공업·물류 및 주거용 부동산 거래의 최전선에서 30년간 현장을 발로 뛰며 체득한 실무 데이터와 노하우를 기록하는 ‘공인중개사 30년 실무 노트‘입니다.
현장에서 수많은 계약과 협상을 마주하다 보면, 부동산 거래의 성패는 결국 ‘공적 장부와 법적 권리관계를 얼마나 입체적이고 꼼꼼하게 꿰뚫어 보느냐‘에 달려 있음을 매 순간 절감하게 됩니다. 조선시대 실학자 이중환이 『택리지(擇里志)』를 통해 거주의 조건을 철저히 따져보았듯, 현대 부동산 거래 역시 겉으로 보이는 개발 호재나 화려한 조건에 현혹되지 않고 등기부등본의 표제부, 갑구, 을구, 그리고 각종 공적 규제를 완벽하게 해독하는 정밀한 분석에서 안전이 시작됩니다.
컴퓨터공학적 데이터 분석 마인드, 부동산학·경영학적 이론, 그리고 30년간 현장에서 축적한 생생한 자문 경험을 결합하여, 독자 여러분께 가장 정확하고 실효성 있는 실무 가이드를 제공합니다. 수백 년 전 선조들이 입지를 가려내듯 철저한 공적 장부 검증과 세심한 특약 설계로 안전하고 성공적인 자산 운용의 나침반이 되어 드리겠습니다.
부동산 데이터 속 숨겨진 함정을 파헤치고 ‘기술통계와 데이터 정제’로 시장의 진실을 찾아내는 4가지 실전 전략
일반대학원 경영학 및 부동산경영 박사과정의 연구자가 현장의 경험을 바탕으로 엄밀한 연구모형과 가설을 세웠다 하더라도, 막상 수집한 원시 데이터(Raw Data)를 마주하면 수많은 통계적 함정에 직면하게 됩니다. 훌륭한 가설도 잘못되거나 왜곡된 데이터 위에 세워지면 모래성처럼 무너지고 맙니다. 정통 경영학 및 부동산경영 실증연구가 되기 위해서는 통계 프로그램을 무작정 돌리기 전에 평균의 함정을 간파하고, 표준편차를 통해 시장의 위험을 읽어내며, 결측치와 이상치의 본질을 현장 실무의 눈으로 낱낱이 해부하는 치밀한 데이터 정제(Data Cleaning)와 기술통계(Descriptive Statistics) 과정을 거쳐야 합니다. 공인중개사로서 30년간 현장의 최전선을 지키며 체득한 날것 그대로의 경험을 바탕으로, 부동산 데이터의 허상을 깨고 통계적 진실을 건져 올리는 4가지 사례를 구체적으로 살펴보겠습니다.
H3. 13.1 사례 1 ― 토지가격과 초고가 거래 : 평균의 함정과 이상치의 해부
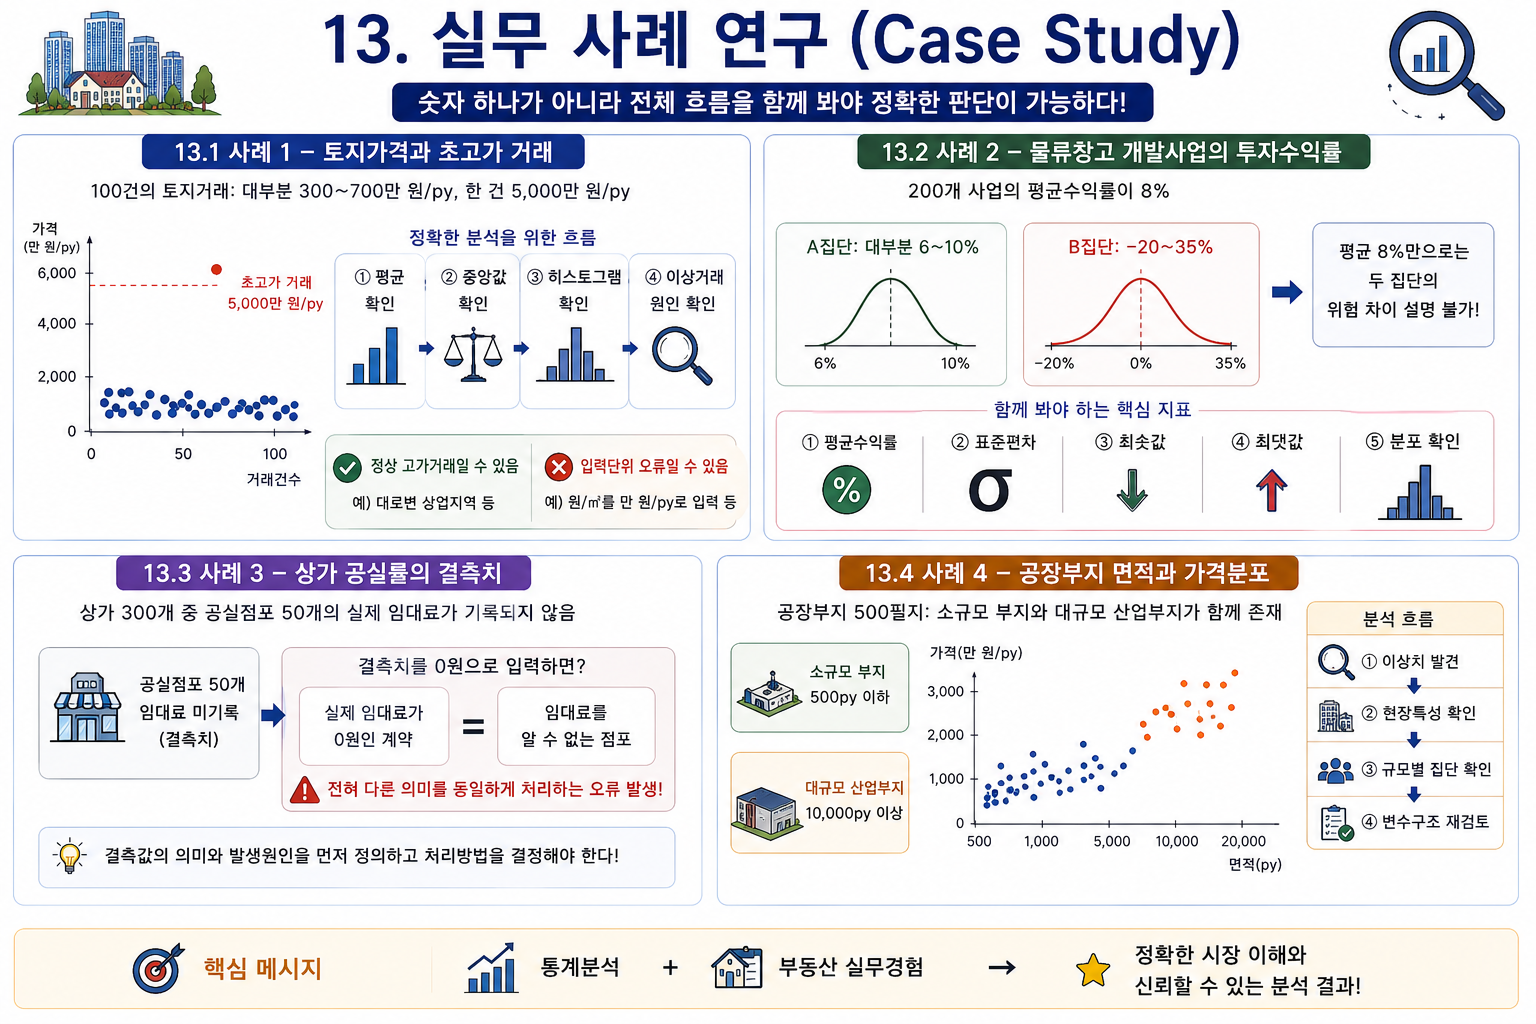
어떤 지역의 토지 거래 100건을 전수조사하여 가격 분석을 수행할 때, 대다수의 거래는 평당 300만 원에서 700만 원 사이에 형성되어 있는데 유독 단 한 건의 거래가 평당 5,000만 원이라는 천문학적인 가격으로 찍혀 있는 상황을 마주하곤 합니다. 이때 초보 연구자들이 무심코 전체 데이터의 ‘평균가격’만 산출해 제시한다면, 그 지역의 시장가격은 실제보다 엄청나게 부풀려져 왜곡되고 맙니다.
이러한 통계적 함정을 극복하기 위해 다차원적인 검증 프로세스가 필수적입니다. 먼저 평균을 확인한 뒤 중앙값(Median)을 대조하고, 히스토그램을 통해 분포의 모양을 시각적으로 확인한 후 이상거래의 원인을 추적해야 합니다. 만약 그 5,000만 원짜리 토지가 코너 역세권의 대로변 상업지역으로 팔린 정상적인 최고가 거래라면 그것은 시장의 특수한 가치를 반영하는 소중한 표본이지만, 단순한 전산 입력 오류나 지분 쪼개기 거래라면 즉각 수정되거나 걸러져야 합니다. 즉, 통계적 이상치는 무조건 삭제하는 것이 아니라 현장 실무의 눈으로 그 원인을 명확히 규명해야 합니다.
-
실무적 검증 흐름: 현장 관찰(대다수 시세와 격리된 초고가 토지 거래 포착) -> 통계적 교차 검증(평균값과 중앙값의 괴리 확인 및 히스토그램 분포 점검) -> 현장 진단 (정상적 고가 입지인지 전산 입력 오류인지 실무적 원인 규명)
-
교훈: 부동산 데이터에서 평균값 하나만 맹신하면 극단적인 이상치로 인해 시장 전체의 시세가 왜곡되므로, 중앙값과 분포를 함께 보며 이상치의 실체를 철저히 해부해야 합니다.
H3. 13.2 사례 2 ― 물류창고 개발사업의 투자수익률 : 표준편차가 감춘 리스크의 실체
물류창고 개발사업 200건의 데이터를 모아 전체 평균 투자수익률을 계산해 보니 어림잡아 8%라는 꽤 매력적인 수치가 도출되었습니다. 이 숫자만 보면 마치 물류창고 개발은 언제나 안정적으로 8%를 안겨주는 우량 사업처럼 보이기 쉽습니다. 하지만 현장을 아는 전문가라면 이 평온한 평균값 뒤에 숨겨진 서늘한 진실을 의심해야 합니다.
만약 이 200개 사업을 집단별로 뜯어보았을 때, A집단은 대다수 사업이 6%에서 10% 사이의 안정적인 수익률을 내는 반면, B집단은 어떤 사업은 35% 대박이 터졌지만 어떤 사업은 -20%의 치명적인 손실을 보며 파산 직전에 이르렀다면 이야기 완전히 달라집니다. 전체 평균인 8%는 이 두 극단적 집단의 위험을 완전히 지워버린 허상에 불과합니다. 따라서 투자 분석과 박사논문 실증에서는 평균수익률뿐만 아니라 표준편차(SD), 최솟값·최댓값, 그리고 전체 분포를 반드시 함께 보며 시장이 품고 있는 잠재적 변동성과 위험의 크기를 입체적으로 진단해야 합니다.
-
실무적 검증 흐름: 현장 관찰(평균 수익률은 양호하나 개별 사업별로 극단적인 성과 편차 존재) -> 단일 지표 탈피(평균의 안일함 경계) -> 다차원 위험 분석 설계(표준편차와 최솟·최댓값 분포의 동시 분석을 통한 리스크 진단)
-
교훈: 부동산 시장의 투자 성과를 평가할 때는 겉으로 드러난 평균 수익률에 안주하지 말고, 표준편차와 분포를 통해 시장이 내포한 변동성과 위험의 실체를 냉철하게 파악해야 합니다.
H3. 13.3 사례 3 ― 상가 공실률의 결측치 : 0원과 누락 데이터의 엄격한 분리
상업용 부동산 시장에서 300개의 상가를 대상으로 임대 실태 조사를 수행했는데, 이 중 영업이 완전히 중단되었거나 폐업 상태인 공실 점포 50곳의 실제 임대료 데이터가 기록되지 않은 채 비어 있는 상황을 마주하게 됩니다. 이때 연구자가 아무 생각 없이 이 빈칸(결측치)들을 전부 ‘0원’으로 일괄 입력해 버린다면, 통계 프로그램은 엄청난 오류를 범하게 됩니다.
이 처사는 계약상 임대료가 실제로 ‘0원'(예컨대 무상 임대나 특수 조건)인 점포와, 조사 과정에서 아예 임대료를 파악하지 못해 ‘누락’된 점포를 완전히 동일한 데이터로 취급해 버리는 치명적인 통계적 폭거입니다. 이로 인해 전체 상권의 평균 임대료와 수익성 분석 결과는 사정없이 왜곡됩니다. 따라서 데이터 정제 단계에서는 결측치(Missing Value)가 발생한 근본적인 원인을 추적하고, 그 빈칸이 지닌 의미가 ‘진짜 무상인지’, ‘조사 거부인지’, 혹은 ‘데이터 누락인지’ 명확히 정의한 뒤 적절한 통계적 처리 기준을 세워야 합니다.
-
실무적 검증 흐름: 현장 관찰(공실 상가의 임대료 데이터 누락 현상 발견) -> 무분별한 처리 경계(결측치를 무조건 0원으로 입력하는 오류 방지) -> 정밀 정제 설계(결측치의 발생 원인과 의미를 규명한 뒤 학술적 기준에 따른 처리 적용)
-
교훈: 데이터 속 빈칸인 결측치를 함부로 0원으로 둔갑시키지 말고, 그 결측이 품고 있는 실무적 의미를 엄밀하게 정의한 후 정제 작업을 수행해야 합니다.
H3. 13.4 사례 4 ― 공장부지 면적과 가격분포 : 시장세분화와 데이터 정제의 융합
500필지에 달하는 공장부지 실거래 데이터를 모아 가격 분석을 돌려보는데, 데이터의 퍼짐 정도가 너무 심해 회귀모형의 설명력이 바닥을 치는 현상이 발생했습니다. 초보 분석가들은 이를 단순한 ‘이상치(Outlier)’로 규정하고 시세 범위를 벗어난 데이터들을 무작정 삭제하려 들기 쉽습니다. 하지만 현장 전문가의 눈으로 데이터를 들여다보면 전혀 다른 진실이 숨어 있습니다.
그 가격 분포가 이토록 크게 벌어지는 이유는 에러나 단순 이상치가 아니라, 그 표본 안에 500py 이하의 소규모 도심형 아파트형 공장·소형 부지와 10,000py 이상의 대규모 지방 물류·산업단지 부지라는 성격이 완전히 다른 두 개의 전혀 다른 시장이 하나의 바구니에 섞여 있기 때문입니다. 즉, 가격 편차의 원인은 오류가 아니라 본질적인 시장세분화(Market Segmentation)에 있었습니다. 따라서 이상치를 무작정 지우는 것이 아니라 현장 특성을 확인하고 규모별 집단으로 데이터를 분리하거나 재구조화하는 지혜가 필요합니다.
-
실무적 검증 흐름: 현장 관찰(공장부지 데이터의 극심한 가격 분산과 회귀모형 왜곡 포착) -> 원인 진단(단순 이상치가 아닌 소규모 부지와 대규모 산단 부지의 시장세분화 현상 간파) -> 구조 재편(데이터 무단 삭제를 지양하고 규모별 집단 분리 및 변수구조 재검토)
-
교훈: 데이터가 복잡하게 흩어져 있을 때 무조건 이상치로 치부해 지우지 말고, 부동산 실무적 안목으로 시장세분화의 관점에서 데이터를 재해석하고 정제해야 합니다.
H2. 14. 기술통계에서 회귀분석으로 연결되는 원리
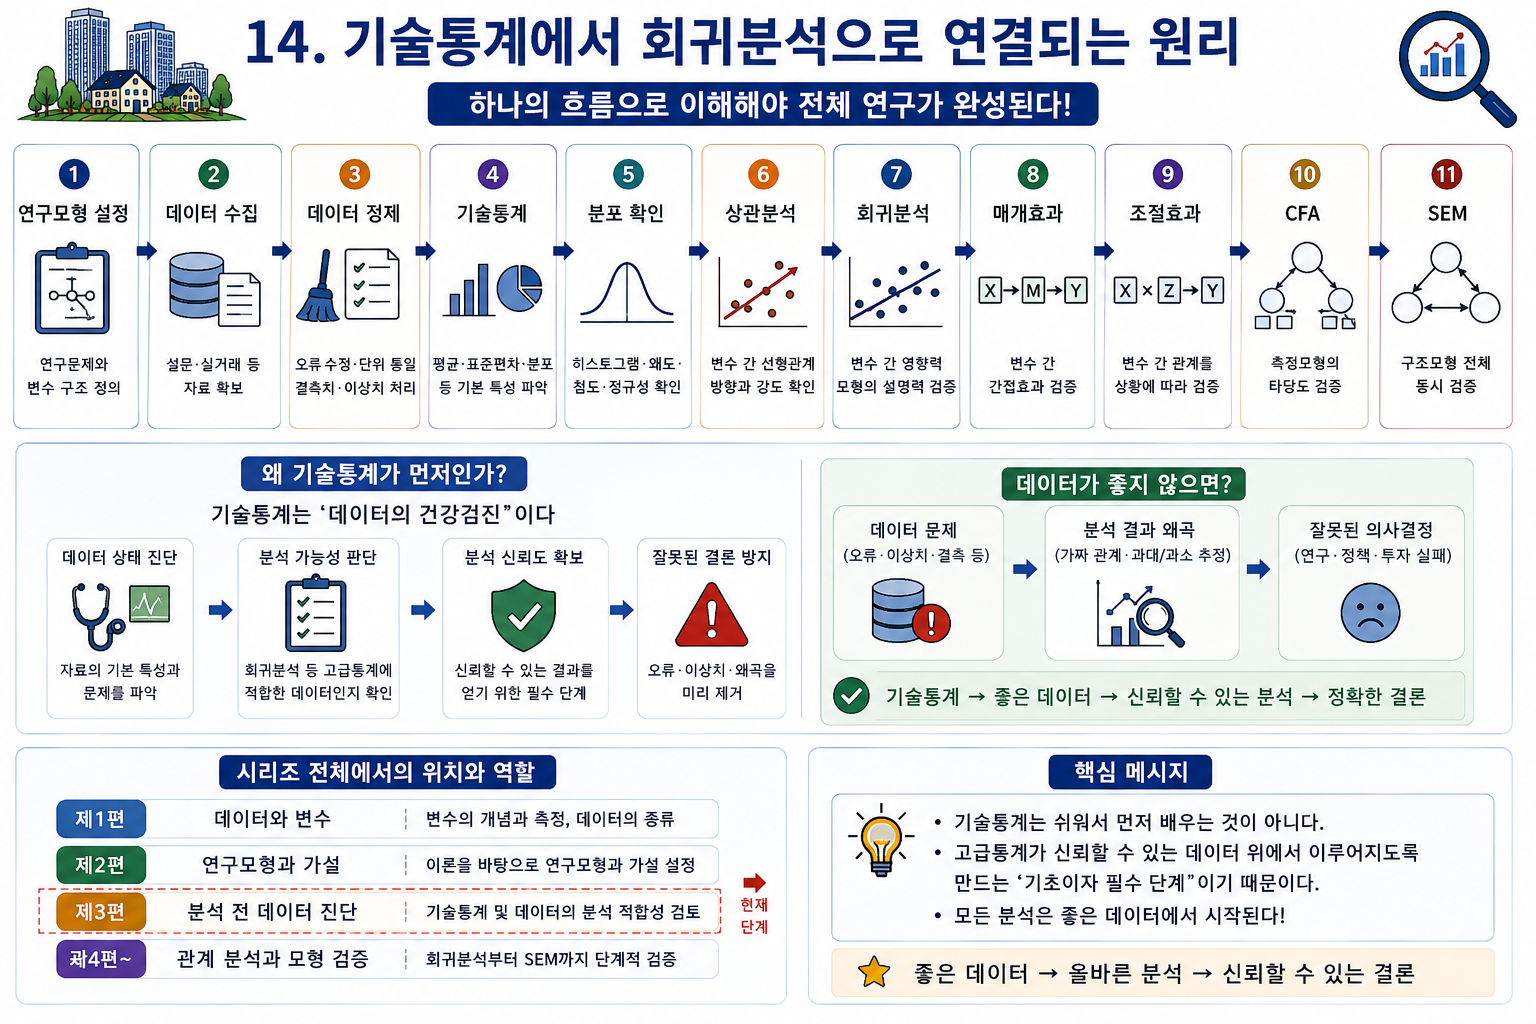
본 시리즈 전체에서 가장 중요한 것은 각각의 통계기법을 분리해서 외우지 않는 것이다.
연구모형 설정 → 데이터 수집 → 데이터 정제 → 기술통계 → 분포 확인 → 상관분석 → 회귀분석 → 매개효과 → 조절효과 → CFA → SEM
이라는 하나의 흐름으로 이해해야 한다.
제1편에서는 데이터와 변수를 배웠다.
제2편에서는 연구모형과 연구가설을 만들었다.
제3편에서는 그 가설을 검증할 데이터가 분석 가능한 상태인지 확인한다.
그리고 제4편부터 변수 사이 관계를 본격적으로 분석한다.
따라서 기술통계는 쉬운 통계여서 먼저 배우는 것이 아니다.
고급통계가 신뢰할 수 있는 데이터 위에서 이루어지도록 만드는 기초단계이기 때문에 먼저 수행하는 것이다.
H2. 15. 실무 체크리스트
박사논문의 본 분석을 시작하기 전에 최소한 다음 사항을 확인하는 것이 좋다.
데이터 출처가 명확한가?
연구기간이 동일하거나 비교 가능한가?
변수의 단위가 통일되어 있는가?
가격자료의 기준이 동일한가?
결측치가 얼마나 있는가?
결측치가 특정 집단에 집중되어 있는가?
극단적인 이상치가 있는가?
이상치가 오류인지 실제 거래인지 확인했는가?
평균과 중앙값 차이가 큰가?
표준편차는 어느 정도인가?
히스토그램의 형태는 어떠한가?
왜도가 큰 이유를 설명할 수 있는가?
첨도와 극단값의 관계를 확인했는가?
자료변환이 필요한지 검토했는가?
본 분석에 필요한 통계적 가정을 확인했는가?
H2. 16. 자주 묻는 질문(FAQ)
H3. Q1. 기술통계는 왜 회귀분석보다 먼저 해야 하나요?
데이터의 중심, 산포, 분포, 이상치와 결측치를 먼저 파악해야 회귀분석 결과를 신뢰할 수 있기 때문이다.
H3. Q2. 평균과 중앙값 중 어느 것이 더 좋은가요?
어느 하나가 항상 더 좋은 것은 아니다. 자료가 대칭적이면 두 값이 유사할 수 있지만 초고가 거래처럼 극단값이 존재하면 중앙값이 시장의 중심을 추가로 설명하는 데 유용하다.
H3. Q3. 표준편차가 크면 투자위험이 높다는 뜻인가요?
반드시 그렇지는 않다. 자료의 변동성이 크다는 의미이며 그 원인이 시장위험인지 상품의 이질성인지 추가 분석이 필요하다.
H3. Q4. 왜도는 0이어야 정상인가요?
완벽한 대칭분포라면 왜도는 0에 가깝지만 실제 데이터가 반드시 정확히 0일 필요는 없다. 분석방법과 표본특성을 함께 고려해야 한다.
H3. Q5. 첨도가 높으면 무엇을 의심해야 하나요?
극단적인 관측값이나 두꺼운 꼬리가 존재하는지 확인할 필요가 있다. 첨도 하나만으로 결론을 내리지는 않는 것이 좋다.
H3. Q6. 이상치는 모두 삭제해야 하나요?
아니다. 입력오류인지 실제로 중요한 부동산 거래인지 먼저 확인해야 한다. 정상적인 초우량 부동산을 단순히 값이 크다는 이유로 제거하면 시장정보를 잃을 수 있다.
H3. Q7. 결측값을 0으로 처리해도 되나요?
실제 값이 0이라는 의미가 아닌 경우에는 그렇게 처리하면 안 된다. “값이 없음”과 “값이 0”은 서로 다른 정보이다.
H3. Q8. 데이터가 정규분포가 아니면 연구를 못 하나요?
그렇지 않다. 자료의 분포와 분석방법을 고려하여 변환, 강건한 방법, 다른 모형 등을 검토할 수 있다. 중요한 것은 분포를 확인하지 않고 기계적으로 분석하는 것을 피하는 것이다.
H3. Q9. 부동산 가격에는 로그변환을 많이 사용하는 이유가 무엇인가요?
가격자료가 오른쪽으로 크게 치우치는 경우가 있어 분포특성과 연구모형에 따라 로그변환을 검토할 수 있다. 다만 변환은 자동으로 하는 것이 아니라 해석과 연구목적을 고려해야 한다.
H3. Q10. 기술통계 다음에는 무엇을 공부해야 하나요?
다음 단계에서는 두 변수가 함께 움직이는지 확인하는 상관분석을 배우고, 상관관계와 인과관계를 명확하게 구별하게 된다.
H2. 17. 연구자의 실무 의견(Author’s Insight)
부동산 실무에서 숫자를 그대로 믿는 것은 위험하다.
실거래가격 한 건을 보더라도
정상거래인가?
지분거래인가?
건물이 포함되어 있는가?
도로조건은 동일한가?
용도지역이 같은가?
거래시점은 언제인가?
라는 질문이 필요하다.
통계분석도 동일하다.
좋은 데이터 분석은 프로그램에서 시작되는 것이 아니라 숫자의 의미를 확인하는 과정에서 시작된다.
공인중개사 실무에서는 흔히 현장확인의 중요성을 강조한다.
통계에서도 데이터에 대한 “현장확인”이 필요하다.
예를 들어 토지가격 5,000만 원/py라는 이상값을 발견했다면 단순히 SPSS에서 삭제 버튼을 누르는 것이 아니라 왜 그러한 값이 발생했는지를 부동산 전문지식으로 확인해야 한다.
대로변 상업지역인지,
개발호재가 있는지,
특수거래인지,
단위입력 오류인지
확인해야 한다.
따라서 부동산 연구자의 강점은 통계와 현장을 연결할 수 있다는 데 있다.
데이터 → 통계적 이상 발견 → 부동산 실무적 원인 확인 → 분석방법 결정 → 결과해석
의 과정이 중요하다.
박사논문의 통계는 숫자를 아름답게 만드는 작업이 아니라 실제 시장현상을 가능한 한 정확하게 설명하는 작업이어야 한다.
H2. 18. 정책 제언 및 부동산 투자 전략
정부나 공공기관의 부동산시장 통계, 기업의 투자보고서, 개인의 투자분석에서도 평균값 하나에 지나치게 의존하면 시장을 잘못 해석할 수 있다.
예를 들어 어떤 지역의 평균토지가격이 20% 상승했다고 하더라도 다음을 함께 확인해야 한다.
거래량이 증가했는가?
중앙가격도 상승했는가?
특정 대형거래 때문인가?
가격의 표준편차가 확대되었는가?
특정 용도지역만 상승했는가?
거래구성이 달라졌는가?
따라서 부동산 투자판단에서는
평균가격 → 중앙가격 → 거래량 → 분포 → 변동성 → 이상거래 → 시장원인
을 함께 분석하는 것이 바람직하다.
개발사업 역시 평균수익률만 보는 것이 아니라
평균수익률 → 표준편차 → 최악의 결과 → 최고 결과 → 금융조건 → 시장수요
를 함께 검토해야 한다.
기술통계는 투자판단의 결론을 대신하지 않는다.
그러나 잘못된 숫자에 의해 잘못된 결론을 내리는 위험을 줄이는 중요한 도구가 될 수 있다.
H2. 19. 결론(Conclusion)
박사논문에서 고급통계를 잘하기 위해서는 먼저 데이터를 제대로 읽을 수 있어야 한다.
데이터 분석의 기본 흐름은 다음과 같다.
데이터 확보 → 자료출처 확인 → 단위 통일 → 결측치 확인 → 이상치 확인 → 평균·중앙값 → 분산·표준편차 → 분포 → 왜도·첨도 → 상관분석 → 회귀분석
평균은 자료의 중심을 보여준다.
중앙값은 극단값의 영향을 상대적으로 덜 받는 중심을 보여준다.
표준편차는 자료가 얼마나 퍼져 있는지를 보여준다.
왜도는 분포가 어느 방향으로 치우쳤는지를 보여준다.
첨도는 꼬리와 극단값 특성을 이해하는 데 도움을 준다.
이상치는 단순히 제거할 값이 아니라 원인을 확인해야 하는 관측값이다.
결측치는 0이 아니라 “정보가 관측되지 않은 상태”이다.
이러한 기초를 이해하면 다음 단계에서 배우는 상관분석과 회귀분석의 결과를 훨씬 더 정확하게 해석할 수 있다.
통계의 목적은 복잡한 분석을 많이 하는 데 있지 않다.
현실의 데이터를 정확하게 이해하고,
그 데이터가 연구가설을 얼마나 뒷받침하는지를 검증하는 데 있다.
H2. 20. 참고문헌(References)
- 「NIST/SEMATECH e-Handbook of Statistical Methods」
- 미국 NIST의 공식 통계 핸드북으로 탐색적 자료분석(EDA), 분포, 중심·산포, 이상치, 통계적 가정과 데이터 분석방법을 체계적으로 설명하는 신뢰도 높은 통계 참고자료이다.
- 바로가기: NIST 공식 e-Handbook
- 「NIST/SEMATECH, Measures of Skewness and Kurtosis」
- 왜도(Skewness)를 분포의 비대칭 정도로, 첨도(Kurtosis)를 정규분포와 비교한 꼬리 특성과 관련된 지표로 설명한다. 부동산 가격처럼 오른쪽으로 치우친 자료의 분포를 점검할 때 유용하다.
- 바로가기: NIST 공식 자료
- 「NIST/SEMATECH, Measures of Location」
- 평균(Mean), 중앙값(Median) 등 자료의 대표적인 중심위치 측정방법을 설명하며, 극단값의 영향을 받는 정도가 서로 다르다는 점을 이해하는 데 유용한 공식 통계자료이다.
- 바로가기: NIST 공식 자료
- 「NIST/SEMATECH, What Are Outliers in the Data?」
- 이상치를 다른 관측값으로부터 비정상적으로 떨어진 관측값으로 설명하고, 이상치를 제거하기 전에 발생 원인과 자료의 정상적인 특성을 먼저 검토해야 함을 강조한다. 부동산 특수거래·초고가 거래·입력오류를 구별할 때 중요한 기준이다.
- 바로가기: NIST 공식 자료
- 「NIST/SEMATECH, Exploratory Data Analysis」
- 탐색적 자료분석(EDA)을 통해 데이터의 구조와 패턴을 파악하고, 이상치·이상현상을 발견하며, 통계적 가정을 점검하는 방법을 체계적으로 설명한다. 본격적인 부동산 통계분석 전에 실시하는 자료점검의 이론적 근거로 활용할 수 있다.
- 바로가기: NIST 공식 EDA 자료
- 「Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E., Multivariate Data Analysis, 8th Edition」
- 자료점검, 탐색적 요인분석, 다중회귀분석, 로지스틱 회귀분석 및 구조방정식모형 등 경영학·사회과학의 다변량 분석방법을 체계적으로 다루는 대표적인 연구방법론 문헌이다.
- 바로가기: Cengage 공식 도서 페이지
- 「Tabachnick, B. G., & Fidell, L. S., Using Multivariate Statistics, 7th Edition」
- 본격적인 다변량 분석에 앞서 자료를 점검하는 방법부터 다중회귀, 로지스틱 회귀, 요인분석, 구조방정식모형까지 폭넓게 다룬다. 특히 분석 전 데이터 스크리닝과 결측자료 처리 등을 함께 검토할 수 있는 대표적인 방법론 문헌이다.
- 바로가기: Pearson 공식 도서 페이지
- 「Field, A., Discovering Statistics Using IBM SPSS Statistics, 6th Edition」
- 기초 통계이론부터 회귀분석, 요인분석, 다층모형까지 실제 데이터를 활용해 단계적으로 설명하는 응용통계 문헌이다. SPSS를 활용하는 박사과정 연구자가 통계결과의 의미와 해석방법을 익히는 데 유용하다.
- 바로가기: SAGE Publications 공식 도서 페이지
- 「Google Search Central, Creating Helpful, Reliable, People-First Content」
- Google은 검색순위 조작을 목적으로 한 콘텐츠보다 독자에게 실질적으로 도움이 되는 신뢰성 있고 사람 중심의 콘텐츠를 권장한다. 독창적인 정보·연구·분석, 충분한 설명, 명확한 출처와 실제 전문성을 중요하게 제시한다.
- 바로가기: Google Search Central 공식 가이드
- 「Google Search Essentials」
- Google 검색에 표시되기 위한 기술적 요구사항, 스팸 정책 및 핵심 모범사례를 제시한다. 특히 유용하고 신뢰할 수 있는 사람 중심 콘텐츠, 검색자가 사용하는 표현의 적절한 배치, 크롤링 가능한 링크 구조 등을 기본적인 검색 최적화 원칙으로 안내한다.
- 바로가기: Google Search Essentials 공식 가이드
-
[실무 유의사항]
- 부동산 가격·임대료·토지가격 자료는 이상치와 왜도가 크게 나타날 수 있으므로 평균만으로 시장을 판단하지 말고 중앙값·표준편차·IQR·왜도 등을 함께 검토하는 것이 좋다.
- 이상치는 단순히 삭제하지 말고 특수관계 거래, 일괄거래, 개발호재, 입력오류 등 발생 원인을 먼저 확인해야 한다. NIST 역시 이상치 제거 전에 그 원인을 조사할 것을 강조한다.
- 논문에서 로그변환이나 이상치 제거를 실시했다면 적용 기준과 이유를 연구방법에 명확히 기록해야 한다.
- Google SEO는 통계용어나 키워드의 반복보다 실제 경험·독창적 분석·명확한 출처·독자에게 도움이 되는 내용의 품질을 우선하는 방향으로 작성하는 것이 적절하다.